Energia e potenza: CMOS, DVFS, fine di Dennard e acceleratori
Energia di commutazione CV² dimostrata, potenza dinamica e statica, DVFS con potenza proporzionale al cubo della frequenza, argomento energetico per i multicore, legge di Dennard e silicio scuro, core eterogenei e acceleratori.
Per trent’anni ogni generazione di processori è stata più veloce della precedente quasi gratis. Poi, attorno al 2005, il limite è diventato il calore: un chip non può dissipare più di un centinaio di watt per centimetro quadrato senza sistemi di raffreddamento impraticabili, e un telefono non più di pochi watt. Oggi ogni scelta architetturale si misura in prestazioni per watt. In questa lezione dimostriamo da dove viene la potenza dinamica dei circuiti CMOS, perché scendere di frequenza e di tensione fa risparmiare così tanto, la fine della legge di Dennard e le risposte dell’industria: multicore, core eterogenei e acceleratori.
La potenza dinamica
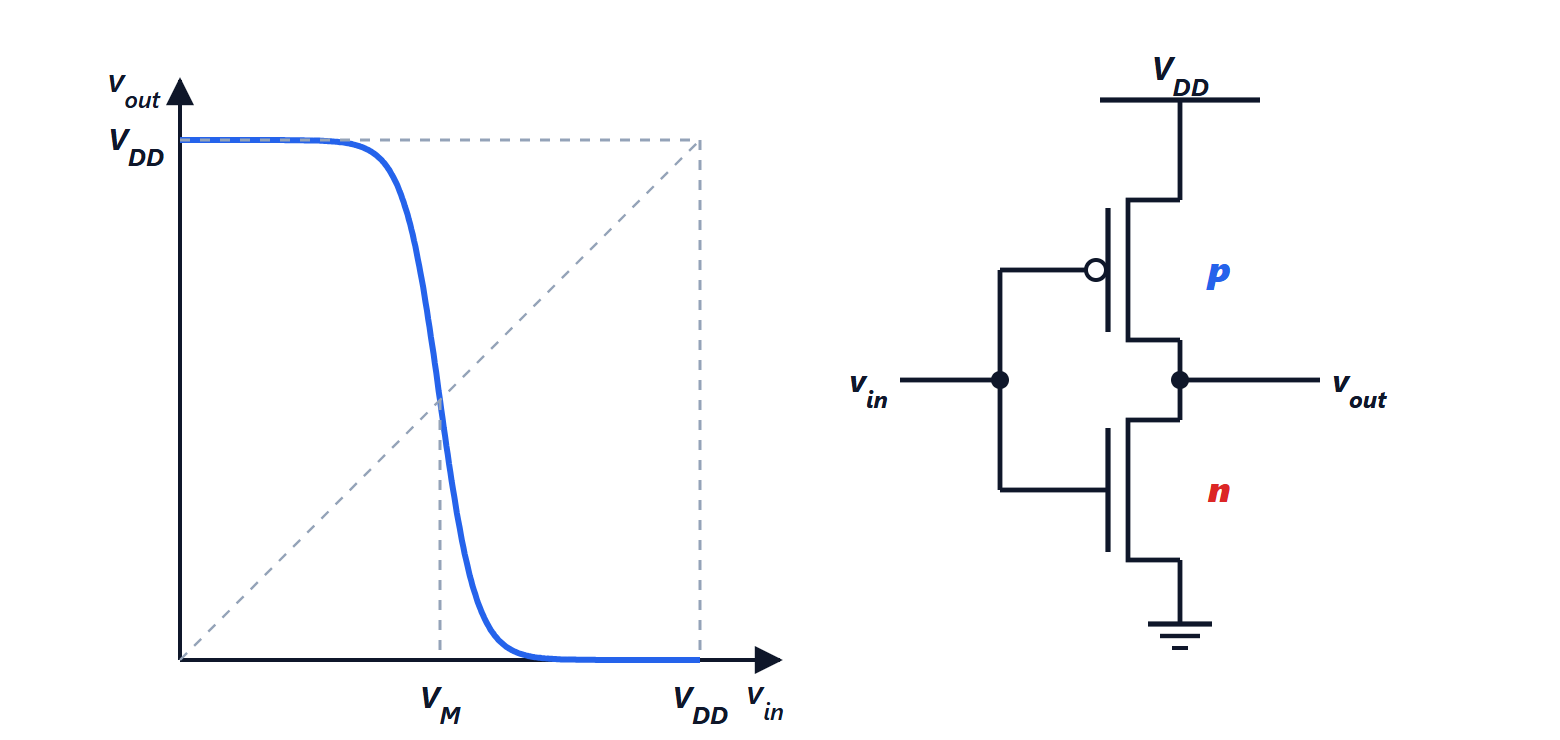
Ogni nodo di un circuito CMOS ha una capacità  (le porte che pilota e i collegamenti). Quando passa da 0 a 1, il transistor p lo carica dall’alimentazione
 ; quando torna a 0, il transistor n lo scarica verso massa (lezione sulla logica CMOS di Dispositivi elettronici).
Teorema. Un ciclo completo di carica e scarica di una capacità alla tensione dissipa l’energia  , qualunque sia la resistenza dei transistor.
Dimostrazione. Durante la carica l’alimentazione fornisce la carica  alla tensione costante : l’energia erogata è
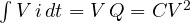 . Alla fine il condensatore ne immagazzina
 ; l’altra metà, , è stata dissipata nella resistenza del transistor, qualunque sia il suo valore (una resistenza grande dà una corrente piccola per un tempo lungo, e il prodotto non cambia). Durante la scarica l’energia immagazzinata viene dissipata nel transistor n. In tutto, per ciclo. ∎
Se un nodo commuta da 0 a 1 in una frazione  dei cicli di clock (il fattore di attività), a frequenza
 :
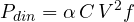
A questa si aggiunge la potenza statica, dovuta alle correnti di perdita dei transistor anche quando sono spenti, che cresce rapidamente quando si abbassa la tensione di soglia e con la temperatura.
Frequenza e tensione
Un transistor commuta più in fretta se è pilotato con una tensione più alta: in un intervallo di funzionamento ragionevole, la frequenza massima è circa proporzionale alla tensione. La variazione dinamica di tensione e frequenza (DVFS) le abbassa insieme quando non serve la massima velocità.
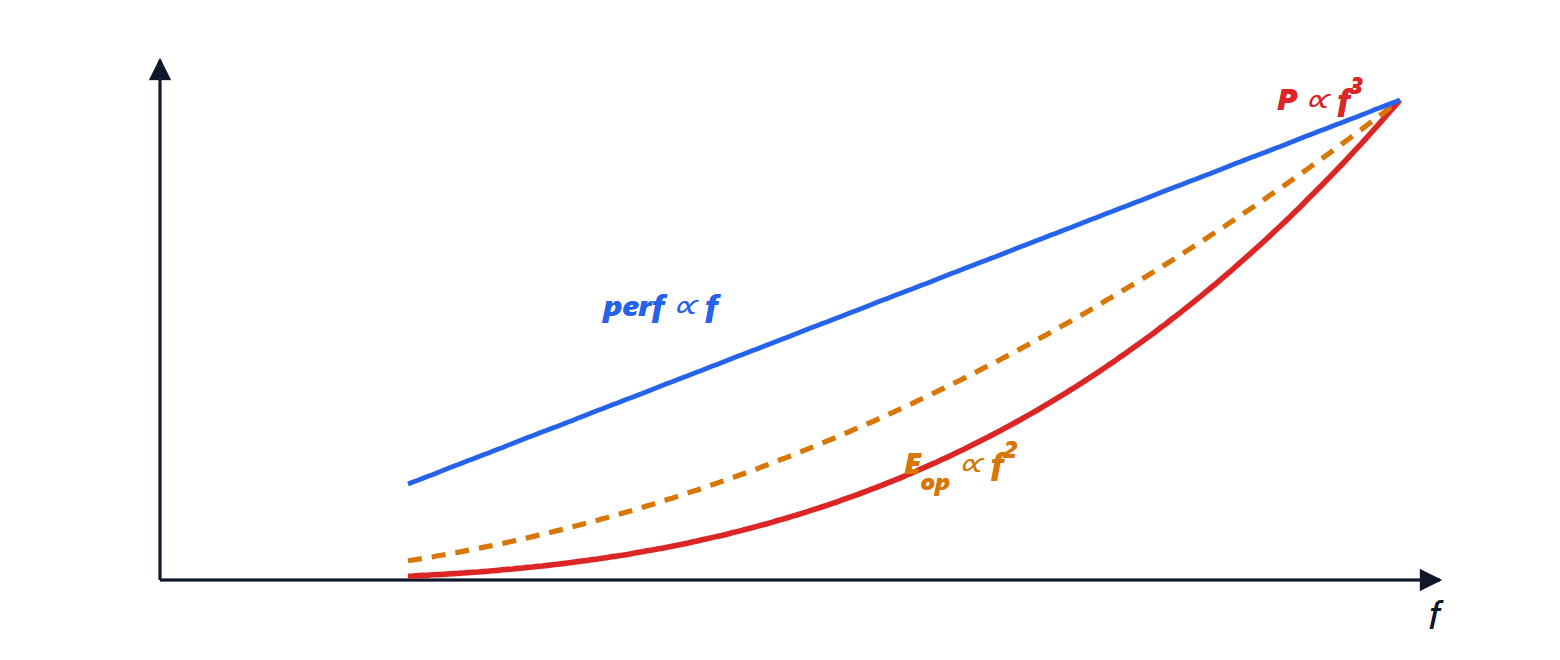
Teorema. Se la tensione è proporzionale alla frequenza, la potenza dinamica è proporzionale a  e l’energia per operazione a
 .
Dimostrazione. Con  ,
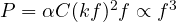 . Il numero di operazioni al secondo è proporzionale a , quindi l’energia per operazione è
 , cioè proporzionale a
 . ∎
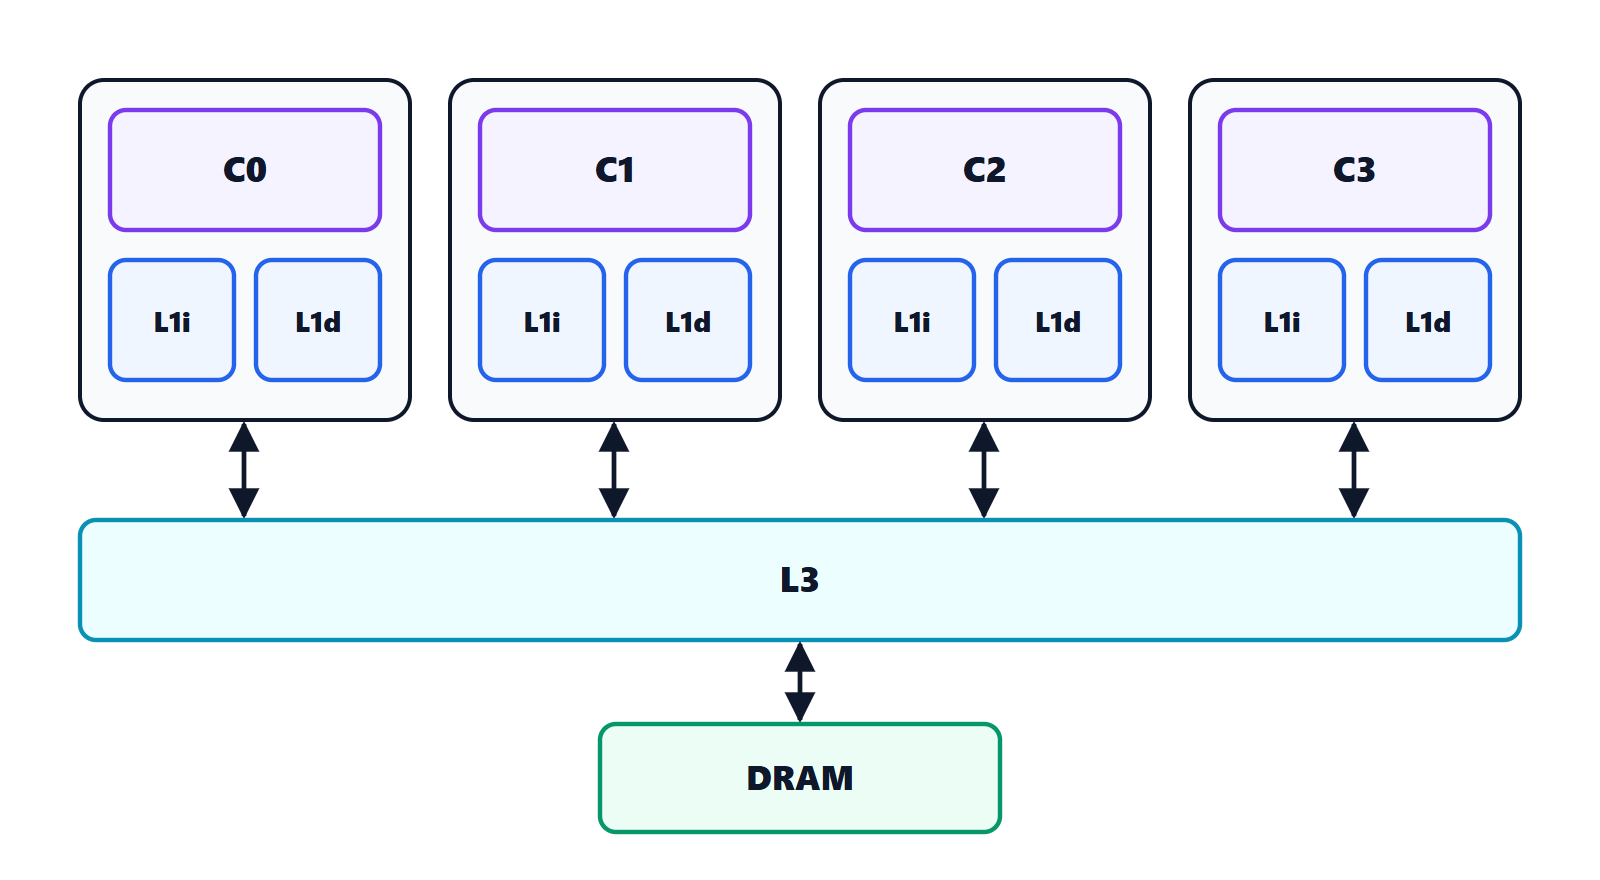
La conseguenza per i multicore. Abbassando frequenza e tensione del 20 %, la potenza di un core scende a  di quella iniziale. Due core così rallentati consumano circa quanto un solo core alla frequenza piena, ma, se il lavoro è parallelizzabile, danno
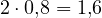 volte le prestazioni. È il ragionamento energetico che ha spinto verso i multicore.
La fine della legge di Dennard
Nel 1974 Robert Dennard mostrò che rimpicciolendo un transistor di un fattore  , tensioni e capacità scendono di e la frequenza sale di : la potenza per transistor scende di
 , proprio quanto cresce il numero di transistor nella stessa area. La densità di potenza resta costante, e ogni generazione era più veloce senza scaldare di più.
Attorno al 2005 la regola si è rotta: la tensione non può più scendere, perché le soglie dei transistor non possono scendere senza far esplodere le correnti di perdita. La densità di potenza ha cominciato a crescere con ogni generazione. Ne è nato il fenomeno del silicio scuro (dark silicon): su un chip moderno c’è più logica di quanta se ne possa accendere tutta insieme senza superare il limite termico.
Le risposte dell’industria
- Multicore e frequenze ferme attorno a 3-5 GHz, come mostra il calcolo precedente.
- Core eterogenei: core grandi e veloci per le parti sequenziali, core piccoli ed efficienti per il lavoro di sottofondo e per quello parallelo (big.LITTLE di ARM, core P ed E di Intel). Il sistema operativo sposta i thread tra gli uni e gli altri.
- Acceleratori specializzati: un circuito che fa una sola cosa, come la decodifica video, la crittografia o il calcolo delle reti neurali (NPU), può essere da 10 a 1000 volte più efficiente di un processore generico, perché non spende energia per prelevare, decodificare e riordinare istruzioni. Lo spazio di silicio “scuro” si riempie di acceleratori che si accendono solo quando servono.
- Spegnere ciò che non lavora: blocchi del chip senza clock (clock gating) o senza alimentazione (power gating) quando sono inattivi; spesso conviene eseguire un lavoro alla massima velocità e poi spegnere tutto (race to idle) piuttosto che eseguirlo lentamente.
Un’ultima lezione dei numeri: muovere i dati costa più che calcolarli. Una somma in virgola mobile a 64 bit costa qualche picojoule; leggere i suoi operandi dalla DRAM costa cento volte di più. Le stesse tecniche che migliorano le prestazioni, località dei dati, suddivisione a blocchi, alta intensità aritmetica, sono quelle che fanno risparmiare energia.