SIMD, GPU e il modello roofline
Estensioni vettoriali dei processori, modello SIMT delle GPU, divergenza e accessi uniti, intensità aritmetica, modello roofline con dimostrazione, esempi del prodotto scalare e del prodotto di matrici.
Molti programmi passano quasi tutto il tempo a ripetere la stessa operazione su grandi quantità di dati: filtrare immagini, moltiplicare matrici, addestrare reti neurali, simulare fisica. Per questo tipo di lavoro conviene un’architettura diversa: un’unica istruzione che agisce su molti dati insieme. In questa lezione vediamo le estensioni vettoriali SIMD dei processori, il modello d’esecuzione delle GPU con i suoi vincoli, e il modello roofline, che con una dimostrazione di due righe dice se un programma è limitato dal calcolo o dalla memoria.
SIMD nei processori
Nella classificazione di Flynn, SIMD (single instruction, multiple data) indica una sola istruzione applicata a più dati. I processori moderni hanno registri vettoriali larghi 128, 256 o 512 bit: un registro da 256 bit contiene 8 numeri in virgola mobile a 32 bit, e un’unica istruzione li somma a coppie con quelli di un altro registro. Le famiglie principali sono SSE e AVX su x86, NEON e SVE su ARM, l’estensione V su RISC-V.
SVE e RISC-V V sono indipendenti dalla lunghezza del vettore: il programma chiede al processore quanti elementi può trattare alla volta e si adatta, così lo stesso codice gira su processori con registri di lunghezza diversa. I compilatori vettorizzano automaticamente i cicli semplici, a patto che non ci siano dipendenze tra le iterazioni e che i dati siano contigui in memoria.
Il modello delle GPU
Una GPU spinge l’idea all’estremo. Contiene decine di multiprocessori di flusso (SM), ciascuno con decine di unità di calcolo semplici, in tutto migliaia. Il programmatore scrive una funzione (il kernel) per un singolo elemento e la lancia su milioni di elementi; l’hardware raggruppa i thread a gruppi di 32 (i warp) che eseguono la stessa istruzione nello stesso momento, ciascuno sui propri dati. È il modello SIMT (single instruction, multiple threads).
Due regole decidono le prestazioni:
- divergenza: se in un warp alcuni thread prendono un ramo di un
ife altri l’altro, i due rami vengono eseguiti uno dopo l’altro, con metà dei thread fermi. Il codice per GPU deve evitare salti che dipendono dai dati del singolo elemento; - accessi uniti (coalescing): se i 32 thread di un warp leggono 32 indirizzi consecutivi, la memoria li serve con un unico trasferimento largo; se leggono indirizzi sparsi, servono 32 trasferimenti.
Le GPU non nascondono la latenza della memoria con cache enormi e l’esecuzione fuori ordine, ma con il numero: ogni SM tiene in vita decine di warp e, quando uno aspetta la memoria, passa a un altro in un ciclo. Serve quindi moltissimo parallelismo, decine di migliaia di thread attivi.
Il modello roofline
Quanto può andare veloce un programma su una certa macchina? Due limiti contano: la prestazione di picco di calcolo  (operazioni al secondo) e la banda della memoria
 (byte al secondo). Il legame tra i due lo dà l’intensità aritmetica del programma, il rapporto tra le operazioni eseguite e i byte trasferiti dalla memoria:
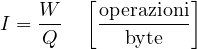
Teorema (roofline). La prestazione raggiungibile è limitata da
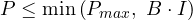
Dimostrazione. Il programma esegue  operazioni e trasferisce
 byte in un tempo
 . Le operazioni non possono essere eseguite più in fretta del picco, quindi
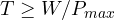 ; i byte non possono essere trasferiti più in fretta della banda, quindi
 . La prestazione è
 , e dalle due disuguaglianze
 e
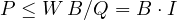 . ∎
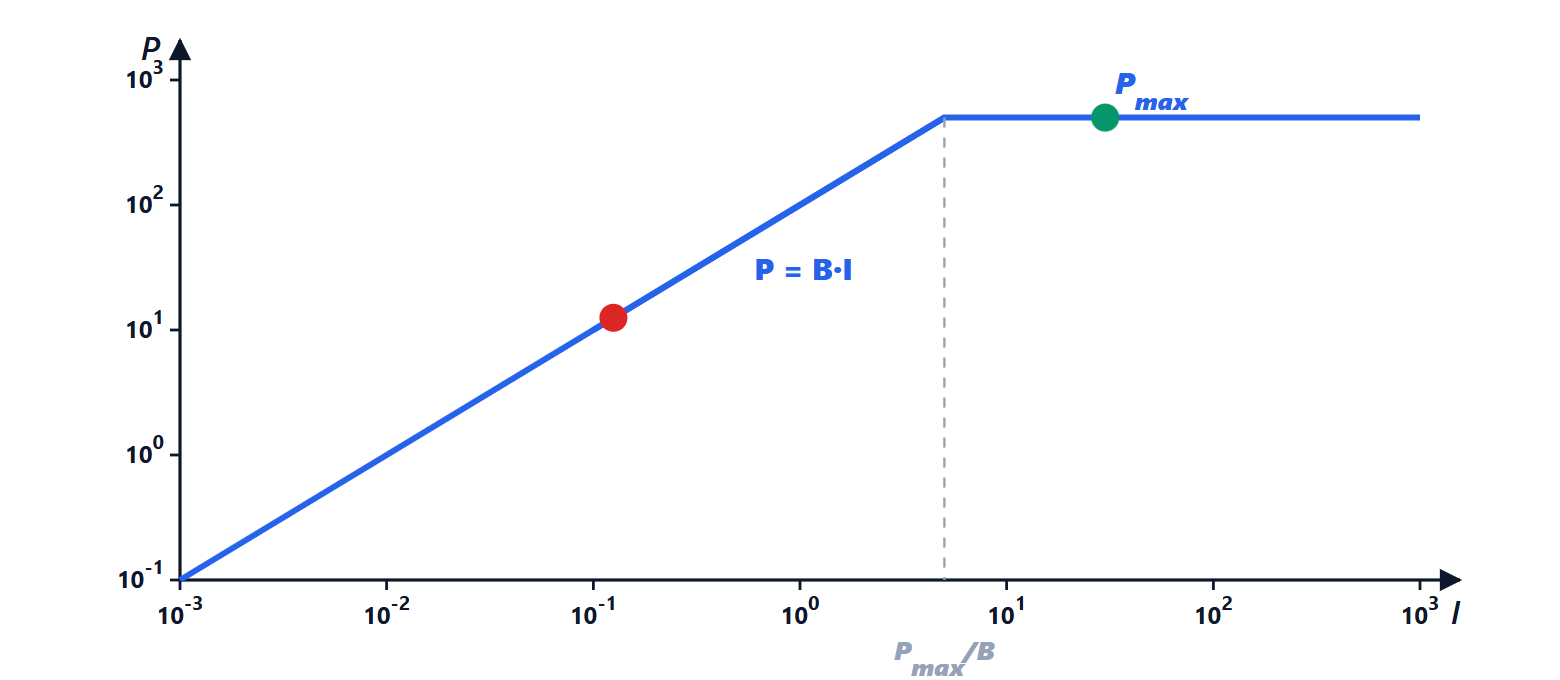
Il grafico in scala logaritmica ha la forma di un tetto: una rampa inclinata a sinistra e un piano orizzontale a destra, che si incontrano nel punto di gomito 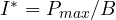 . Un programma con intensità minore di
 è limitato dalla memoria: migliorare il calcolo è inutile, bisogna ridurre i trasferimenti. Uno con intensità maggiore è limitato dal calcolo.
Esempi. Una macchina con 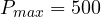 GFLOP/s e
 GB/s ha il gomito a 5 operazioni per byte.
- Il prodotto scalare di due vettori a 64 bit esegue 2 operazioni (una moltiplicazione e una somma) ogni 16 byte letti:
 . La prestazione non può superare
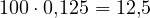 GFLOP/s, il 2,5 % del picco, per quanto sia ottimizzato il codice.
- Il prodotto di matrici con la suddivisione a blocchi (lezione sulle cache) esegue
 operazioni trasferendo circa
 numeri: l’intensità cresce con il lato
 del blocco, e con blocchi abbastanza grandi il programma diventa limitato dal calcolo. Per questo la moltiplicazione di matrici è l’operazione su cui GPU e acceleratori per l’intelligenza artificiale raggiungono le prestazioni dichiarate.
Il modello si estende con più tetti (con e senza unità vettoriali, con dati in cache o in DRAM) e guida l’ottimizzazione: prima si misura dove sta il programma, poi si decide se lavorare sulla località dei dati o sul calcolo.