Architettura dei calcolatori: modello di von Neumann, prestazioni e legge di Amdahl
CPU, memoria e bus, architettura Harvard, ciclo dell'istruzione, equazione delle prestazioni con esempio, legge di Amdahl con dimostrazione ed esempi.
Un calcolatore, dal microcontrollore di una lavatrice al processore di un server, esegue una sequenza di istruzioni prese dalla memoria. L’organizzazione di base è rimasta quella proposta da von Neumann nel 1945; quello che è cambiato enormemente è come la si realizza per andare veloci. In questa lezione vediamo il modello di von Neumann, il ciclo di esecuzione delle istruzioni, come si misurano le prestazioni e la legge di Amdahl, che dice quanto si può sperare di guadagnare da un miglioramento.
Il modello di von Neumann
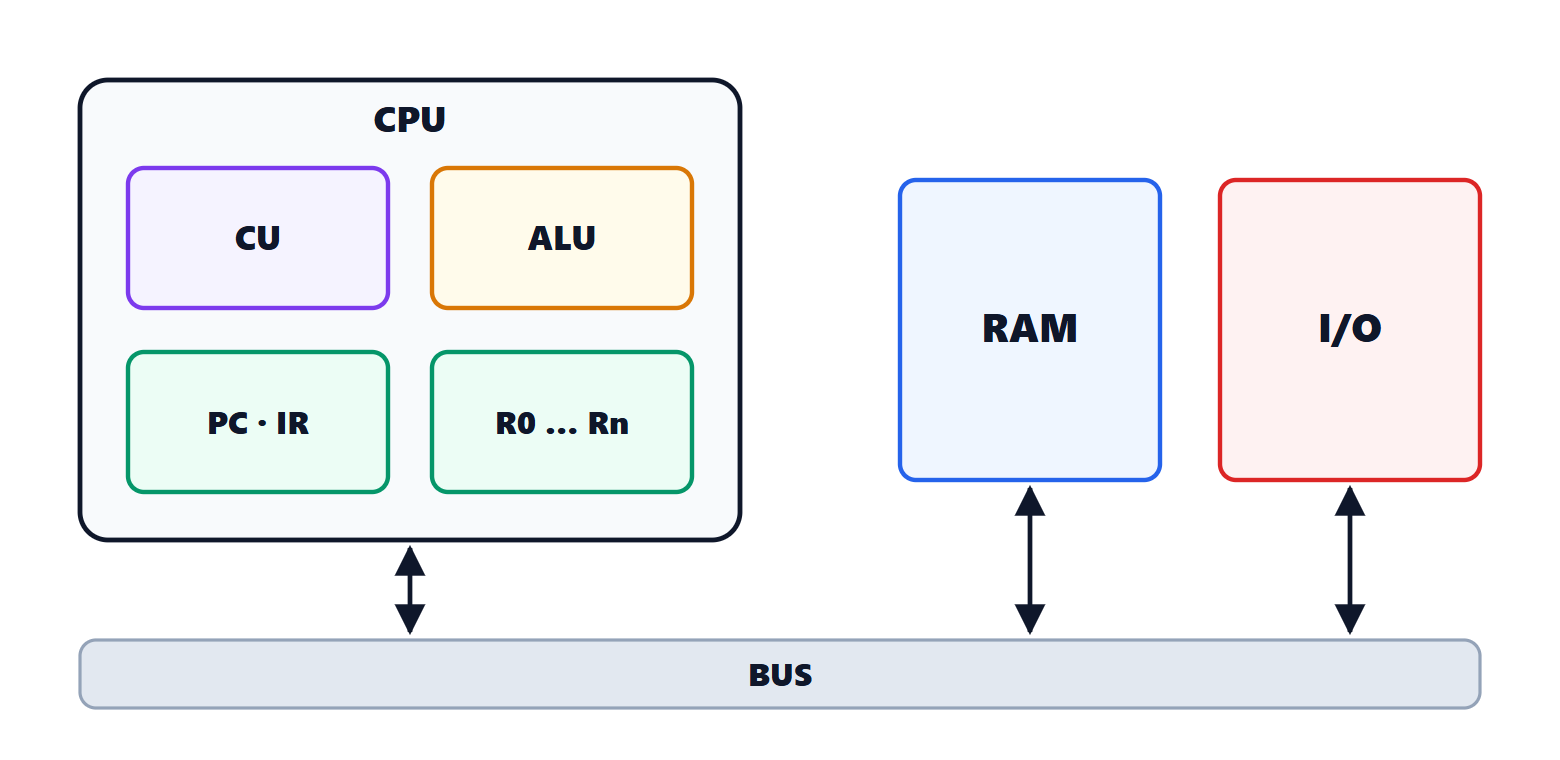
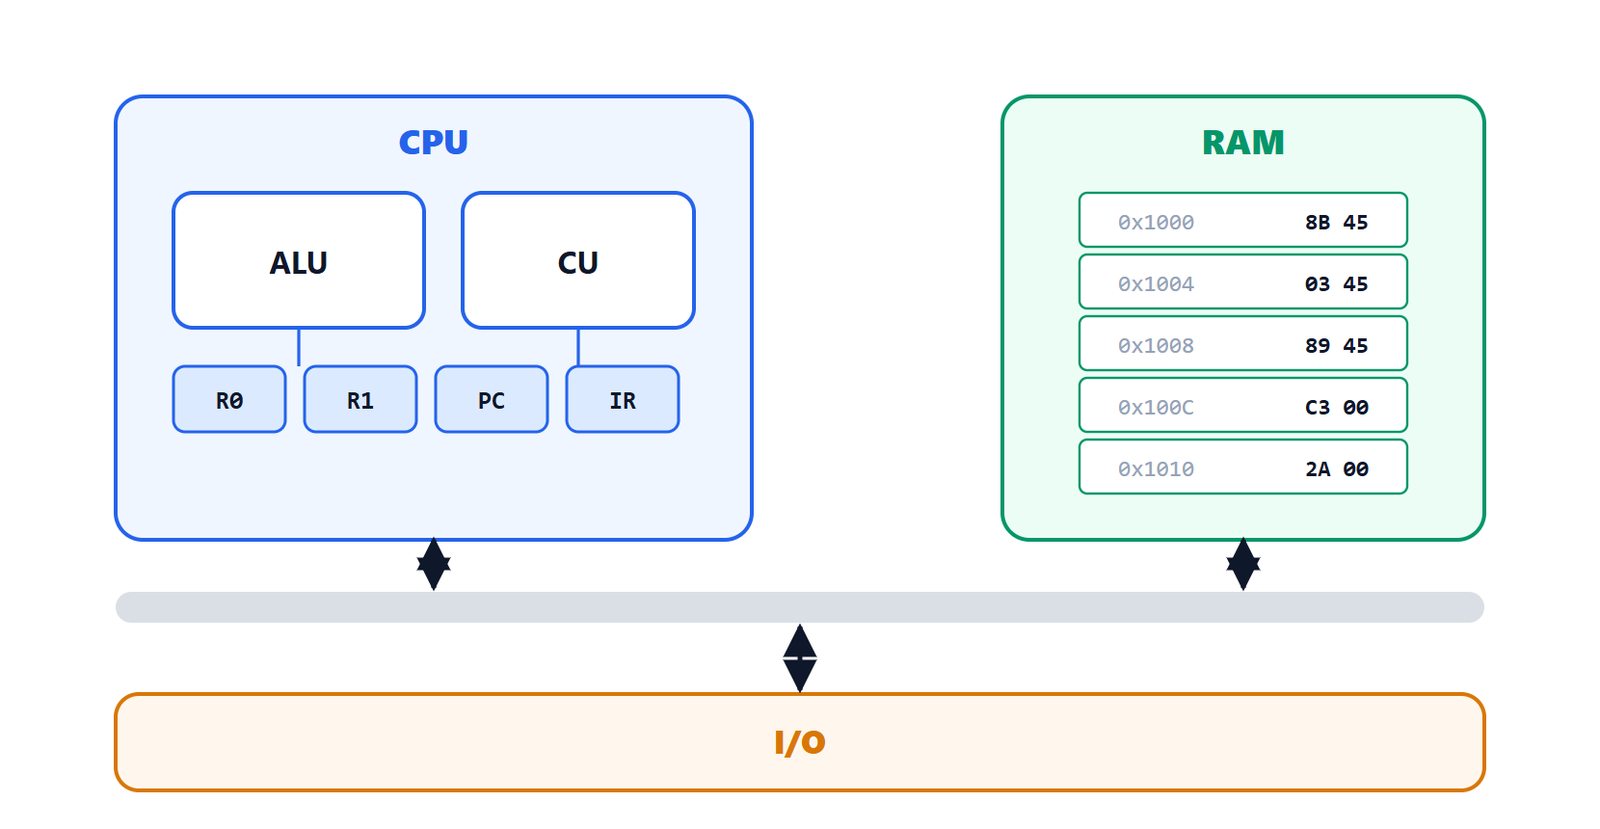
- La CPU contiene l’unità di controllo (CU), che interpreta le istruzioni e comanda il resto; l’unità aritmetico-logica (ALU), che esegue i calcoli; i registri, piccole memorie velocissime. Due registri speciali: il contatore di programma (PC) con l’indirizzo della prossima istruzione e il registro istruzione (IR) con quella in esecuzione.
- La memoria principale contiene sia i dati sia le istruzioni: è l’idea del programma memorizzato, che rende il calcolatore universale (cambiare compito significa caricare un altro programma, non ricablare la macchina).
- I dispositivi di ingresso e uscita (I/O) e il bus che collega tutto.
Nell’architettura Harvard istruzioni e dati stanno in memorie separate, con due bus: si può leggere un’istruzione e un dato nello stesso istante. La usano molti microcontrollori e processori di segnale; i processori moderni sono von Neumann verso la memoria principale, ma hanno cache separate per istruzioni e dati.
Il ciclo dell’istruzione
La CPU ripete all’infinito:
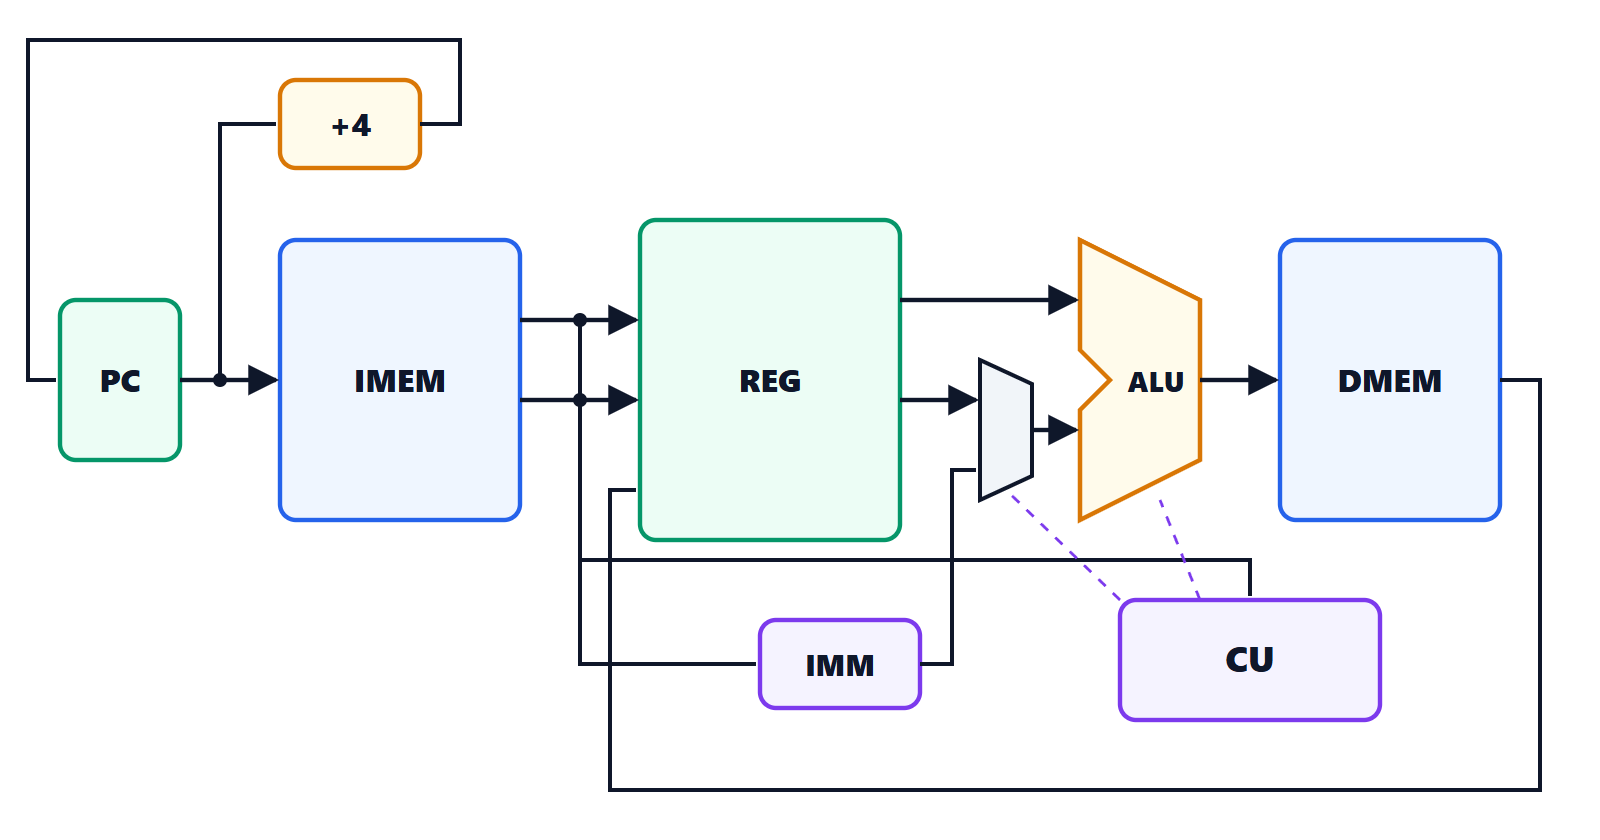
- prelievo (fetch): legge dalla memoria l’istruzione all’indirizzo contenuto nel PC e la mette nell’IR; il PC avanza all’istruzione successiva;
- decodifica: l’unità di controllo capisce di che istruzione si tratta e legge gli operandi dai registri;
- esecuzione: l’ALU calcola, oppure si legge o scrive in memoria;
- scrittura del risultato in un registro.
Un salto modifica il PC, e il prelievo successivo continua da un altro punto del programma: è così che si realizzano cicli, condizioni e chiamate di funzione. Tutto è scandito da un clock, un segnale periodico la cui frequenza (oggi qualche gigahertz) fissa il ritmo dei circuiti.
Misurare le prestazioni
Il tempo di esecuzione di un programma è
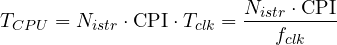
dove  è il numero di istruzioni eseguite e CPI il numero medio di cicli di clock per istruzione.
Esempio.  istruzioni, CPI medio 1,5, clock a 3 GHz:
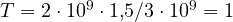 s.
I tre fattori dipendono da cose diverse: dall’algoritmo, dal compilatore e dal set di istruzioni; il CPI dall’organizzazione del processore (pipeline, cache); la frequenza dalla tecnologia e dalla profondità della pipeline. Migliorarne uno spesso peggiora un altro, ed è per questo che la frequenza da sola non dice quale processore è più veloce. Il confronto onesto si fa misurando il tempo su programmi reali (i benchmark).
La legge di Amdahl
Teorema. Se una frazione  del tempo di esecuzione viene accelerata di un fattore
 , l’accelerazione complessiva è
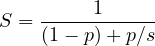
e non supera mai  , per quanto grande sia .
Dimostrazione. Il tempo originale, normalizzato a 1, si divide in una parte non accelerata  e una accelerata , che diventa
 . Il nuovo tempo è
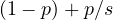 , e l’accelerazione è il rapporto tra il tempo vecchio e il nuovo. Per
 il denominatore tende a . ∎
Esempi.
- Si accelera di 4 volte una parte che occupa l’80% del tempo:
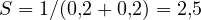 . Anche accelerandola all’infinito non si supera
 .
- Un programma parallelizzabile al 95% su 16 core:
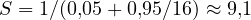 ; con infiniti core, al massimo 20.
La lezione pratica: conviene ottimizzare il caso più frequente, e la parte che resta lenta finisce sempre per dominare. Prima di ottimizzare un programma si misura dove passa davvero il tempo (con un profiler), invece di indovinarlo.
Il resto del corso
Le prossime lezioni seguono il percorso di un’istruzione: come è codificata (set di istruzioni), come l’hardware fa i calcoli (aritmetica), come il processore la esegue (percorso dei dati e pipeline), dove trova i dati (cache e memoria virtuale), come comunica con l’esterno (ingresso e uscita) e come più processori lavorano insieme (parallelismo).