Architecture des ordinateurs : le modèle de von Neumann, performances et loi d'Amdahl
UC, mémoire et bus, l'architecture de Harvard, le cycle d'instruction, l'équation des performances avec un exemple, la loi d'Amdahl avec démonstration et exemples.
https://www.electronics-engineering.com/fr/architecture-de-von-neumann-performances-loi-d-amdahl/
Un ordinateur, du microcontrôleur d’un lave-linge au processeur d’un serveur, exécute une séquence d’instructions prises en mémoire. L’organisation de base est encore celle proposée par von Neumann en 1945 ; ce qui a énormément changé, c’est la façon de la construire pour aller vite. Dans cette leçon, nous traitons le modèle de von Neumann, le cycle d’instruction, la façon de mesurer les performances et la loi d’Amdahl, qui dit combien on peut gagner grâce à une amélioration.
Le modèle de von Neumann
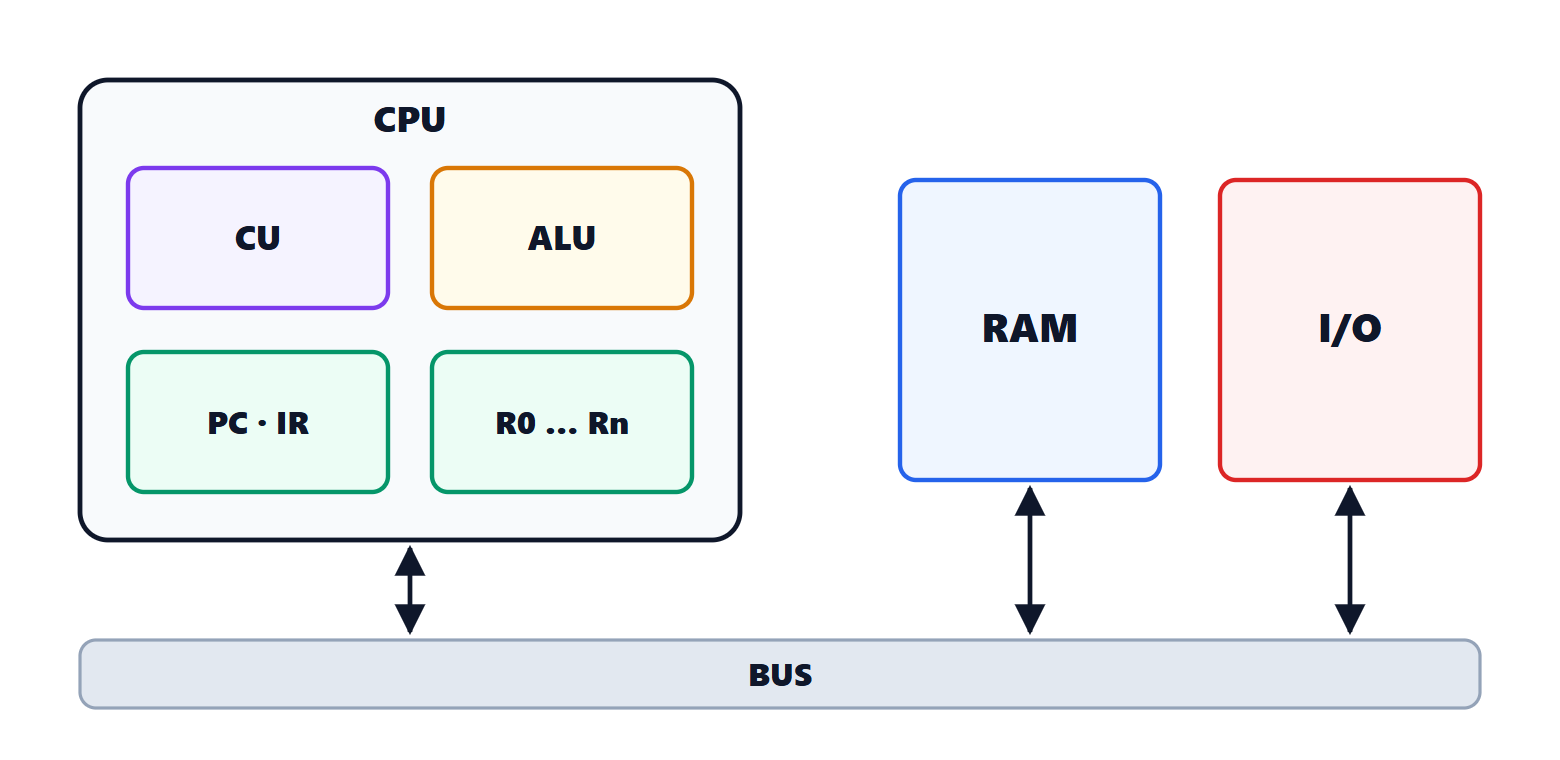
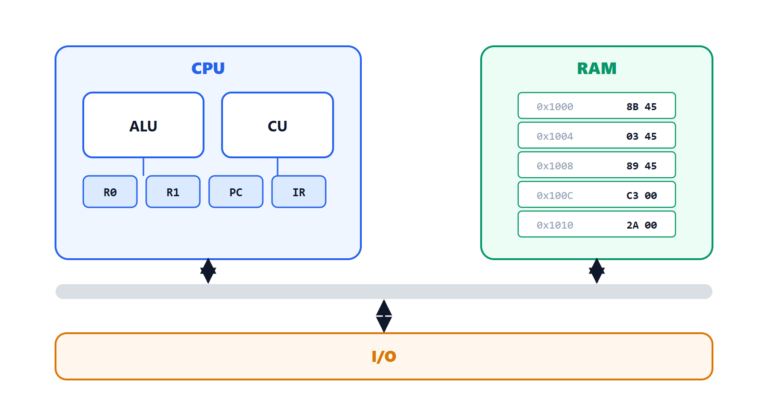
- L’UC (unité centrale, CPU) contient l’unité de commande (CU), qui interprète les instructions et pilote tout le reste ; l’unité arithmétique et logique (ALU), qui fait les calculs ; les registres, de minuscules mémoires très rapides. Deux registres spéciaux : le compteur ordinal (PC) avec l’adresse de l’instruction suivante et le registre d’instruction (IR) avec celle en cours d’exécution.
- La mémoire principale contient à la fois les données et les instructions : c’est l’idée du programme enregistré, qui rend l’ordinateur universel (changer de tâche signifie charger un autre programme, pas recâbler la machine).
- Les périphériques d’entrée et de sortie (E/S) et le bus qui relie le tout.
Dans l’architecture de Harvard, instructions et données vivent dans des mémoires séparées, avec deux bus : on peut lire en même temps une instruction et une donnée. De nombreux microcontrôleurs et processeurs de signal l’utilisent ; les processeurs modernes sont de von Neumann vers la mémoire principale, mais ont des caches séparés pour les instructions et pour les données.
Le cycle d’instruction
L’unité centrale répète indéfiniment :
- lecture (fetch) : lire en mémoire l’instruction à l’adresse contenue dans le PC et la placer dans l’IR ; le PC passe à l’instruction suivante ;
- décodage : l’unité de commande détermine de quelle instruction il s’agit et lit les opérandes dans les registres ;
- exécution : l’ALU calcule, ou la mémoire est lue ou écrite ;
- écriture (write back) du résultat dans un registre.
Un saut modifie le PC, et la lecture suivante continue à partir d’un autre point du programme : c’est ainsi que sont réalisés les boucles, les conditions et les appels de fonctions. Tout est cadencé par une horloge, un signal périodique dont la fréquence (quelques gigahertz aujourd’hui) fixe le rythme des circuits.
Mesurer les performances
Le temps d’exécution d’un programme est
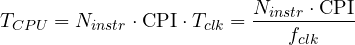
où  est le nombre d’instructions exécutées et CPI le nombre moyen de cycles d’horloge par instruction.
Exemple.  instructions, CPI moyen 1,5, horloge de 3 GHz :
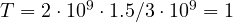 s.
Les trois facteurs dépendent de choses différentes : de l’algorithme, du compilateur et du jeu d’instructions ; le CPI de l’organisation du processeur (pipeline, caches) ; la fréquence de la technologie et de la profondeur du pipeline. En améliorer un en détériore souvent un autre, c’est pourquoi la fréquence seule ne dit pas quel processeur est le plus rapide. Une comparaison honnête mesure le temps sur de vrais programmes (benchmarks).
La loi d’Amdahl
Théorème. Si une fraction  du temps d’exécution est accélérée d’un facteur
 , l’accélération globale est
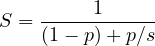
et elle ne dépasse jamais  , aussi grand que soit .
Démonstration. Le temps d’origine, normalisé à 1, se divise en une partie non accélérée,  , et une partie accélérée , qui devient
 . Le nouveau temps est
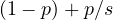 , et l’accélération est le rapport de l’ancien au nouveau temps. Quand
 , le dénominateur tend vers . ∎
Exemples.
- Accélérer de 4 fois une partie qui prend 80 % du temps :
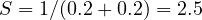 . Même avec une accélération infinie, elle ne peut pas dépasser
 .
- Un programme parallélisable à 95 % sur 16 cœurs :
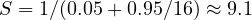 ; avec une infinité de cœurs, au plus 20.
La leçon pratique : optimiser le cas courant, et la partie qui reste lente finit toujours par dominer. Avant d’optimiser un programme, il faut mesurer où le temps passe réellement (avec un profileur) au lieu de deviner.
La suite du cours
Les leçons suivantes suivent le parcours d’une instruction : comment elle est codée (jeu d’instructions), comment le matériel fait l’arithmétique, comment le processeur l’exécute (chemin de données et pipeline), où elle trouve les données (caches et mémoire virtuelle), comment elle dialogue avec le monde extérieur (entrées et sorties) et comment plusieurs processeurs travaillent ensemble (parallélisme).



Ciao, sono l'autore di «Architettura dei calcolatori: modello di von Neumann, prestazioni e legge di Amdahl». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Computer architecture: the von Neumann model, performance and Amdahl's law”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.