Memoria cache: gerarchia, località e tempo medio di accesso
Gerarchia di memoria, località, cache a corrispondenza diretta con divisione dell'indirizzo, AMAT con esempi, associatività, politiche di scrittura, ordine dei cicli.
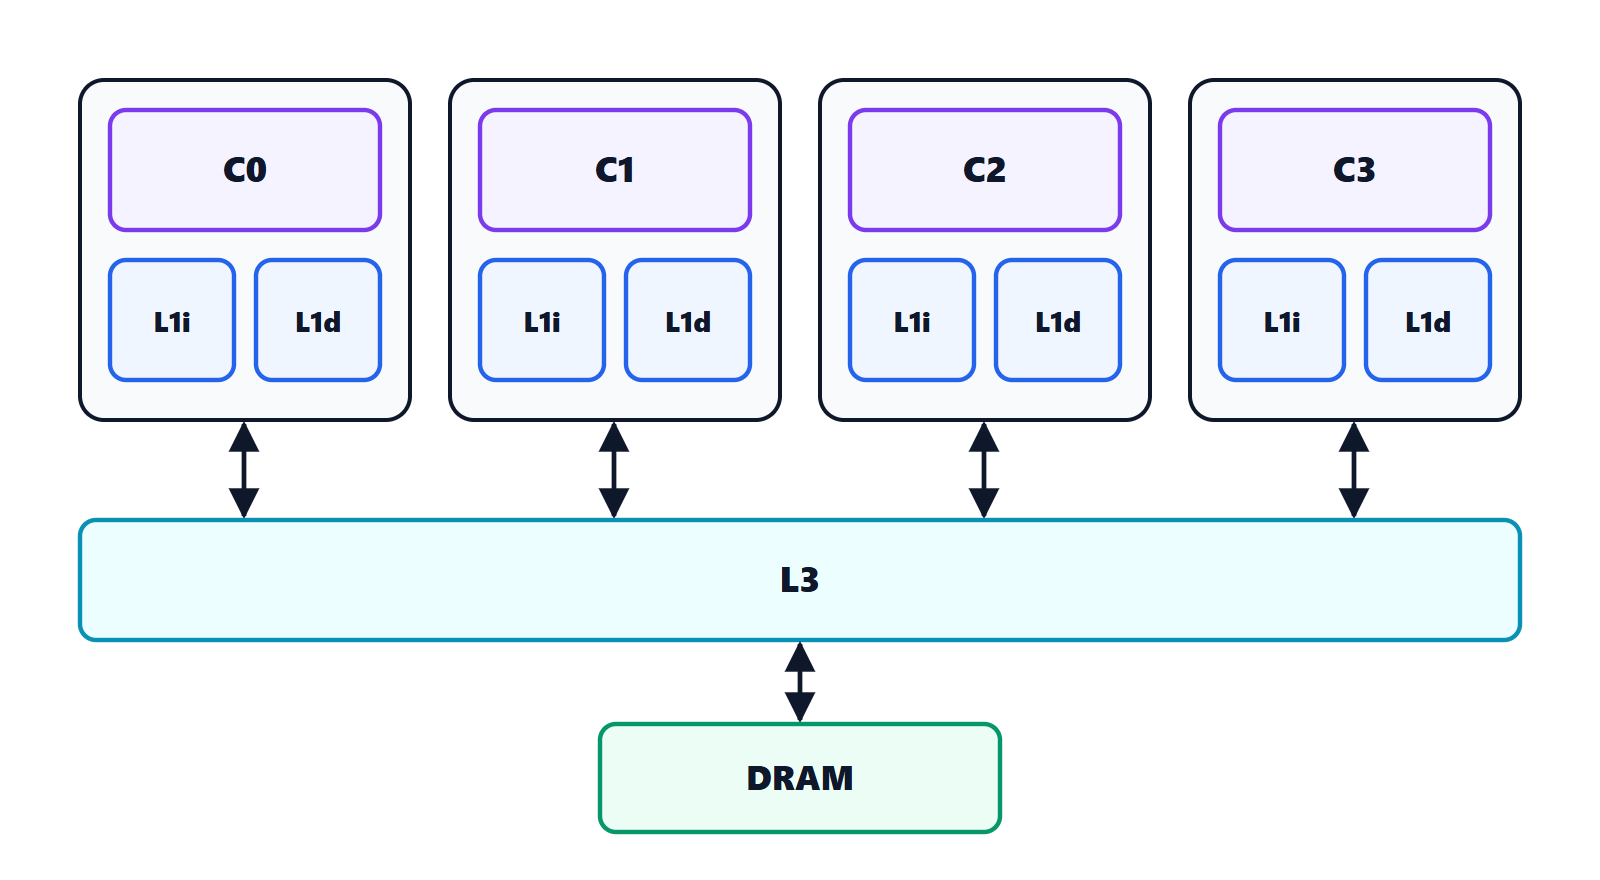
Un processore moderno esegue un’istruzione in meno di un nanosecondo, ma leggere un dato dalla memoria principale (DRAM) richiede circa 80 ns: senza accorgimenti passerebbe quasi tutto il tempo ad aspettare. La soluzione è una gerarchia di memorie: piccole e velocissime vicino al processore, grandi e lente lontano. Funziona grazie a una proprietà dei programmi, la località. In questa lezione vediamo come è fatta una cache, come si calcola il tempo medio di accesso e come il modo di scrivere il codice ne cambia l’efficacia.
La gerarchia
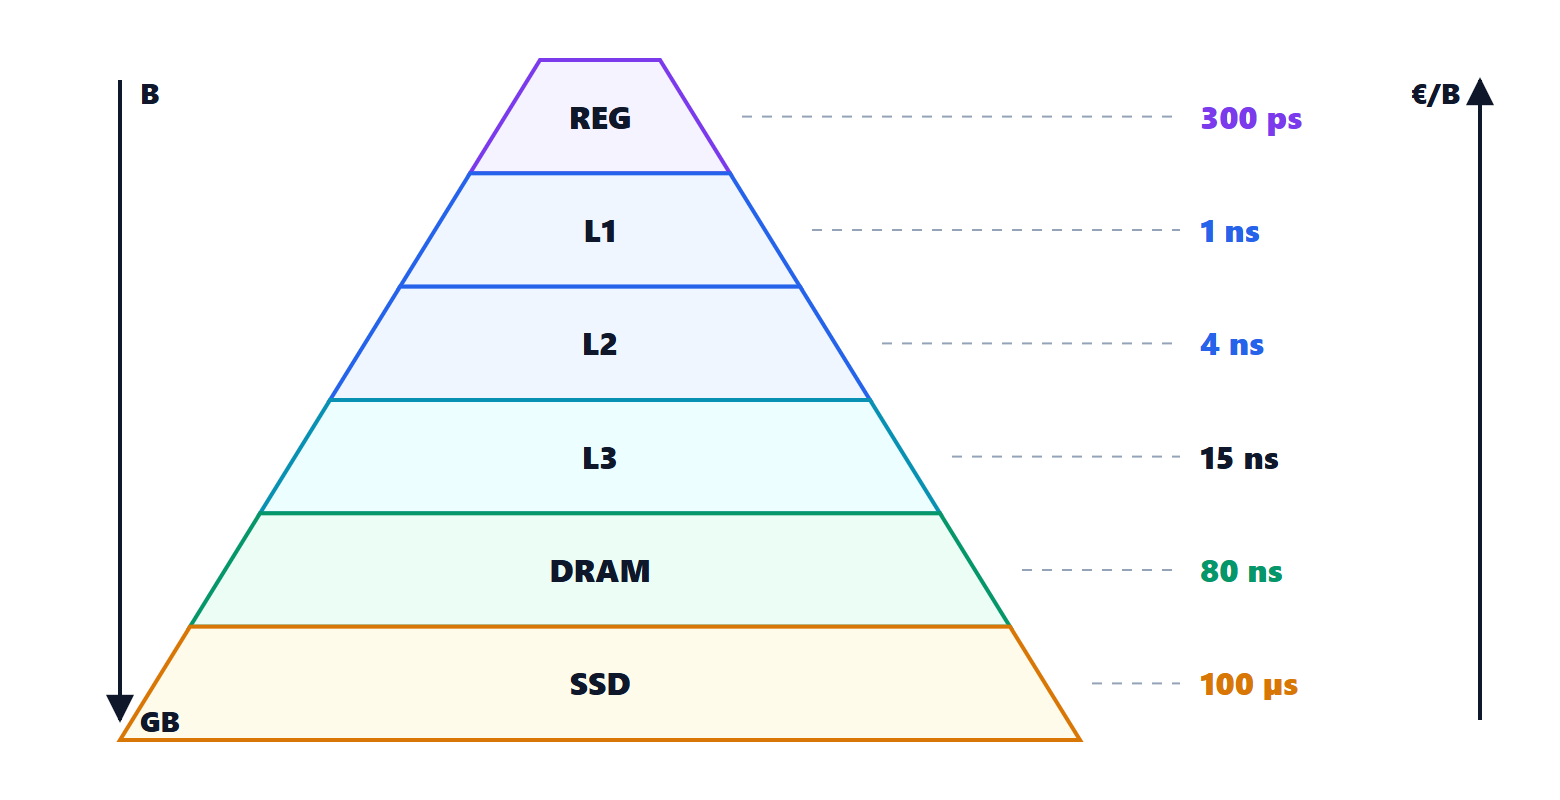
Le memorie veloci (SRAM, nelle cache) costano molto per bit e occupano molta area; quelle capienti (DRAM, flash) sono economiche ma lente. Ogni livello contiene una copia delle parti del livello sotto usate più di recente.
La località
- Località temporale: un dato usato da poco sarà probabilmente riusato presto (le variabili di un ciclo, le istruzioni del ciclo stesso).
- Località spaziale: se si usa un dato, probabilmente si useranno quelli vicini (gli elementi successivi di un vettore, le istruzioni successive).
Per sfruttare la seconda, la cache non copia singoli byte ma blocchi (o linee) di 64 byte: leggere il primo elemento di un vettore porta in cache anche i successivi.
La cache a corrispondenza diretta
Ogni blocco della memoria può stare in una sola riga della cache, scelta da una parte dell’indirizzo. L’indirizzo si divide in tre campi.
Esempio. Cache da 32 KiB con blocchi da 64 byte e indirizzi a 32 bit: le righe sono 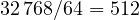 .
- offset (6 bit, perché
 ): quale byte dentro il blocco;
- indice (9 bit, perché
 ): quale riga della cache;
- etichetta (tag, i restanti
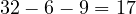 bit): quale dei tanti blocchi che finiscono in quella riga è presente.
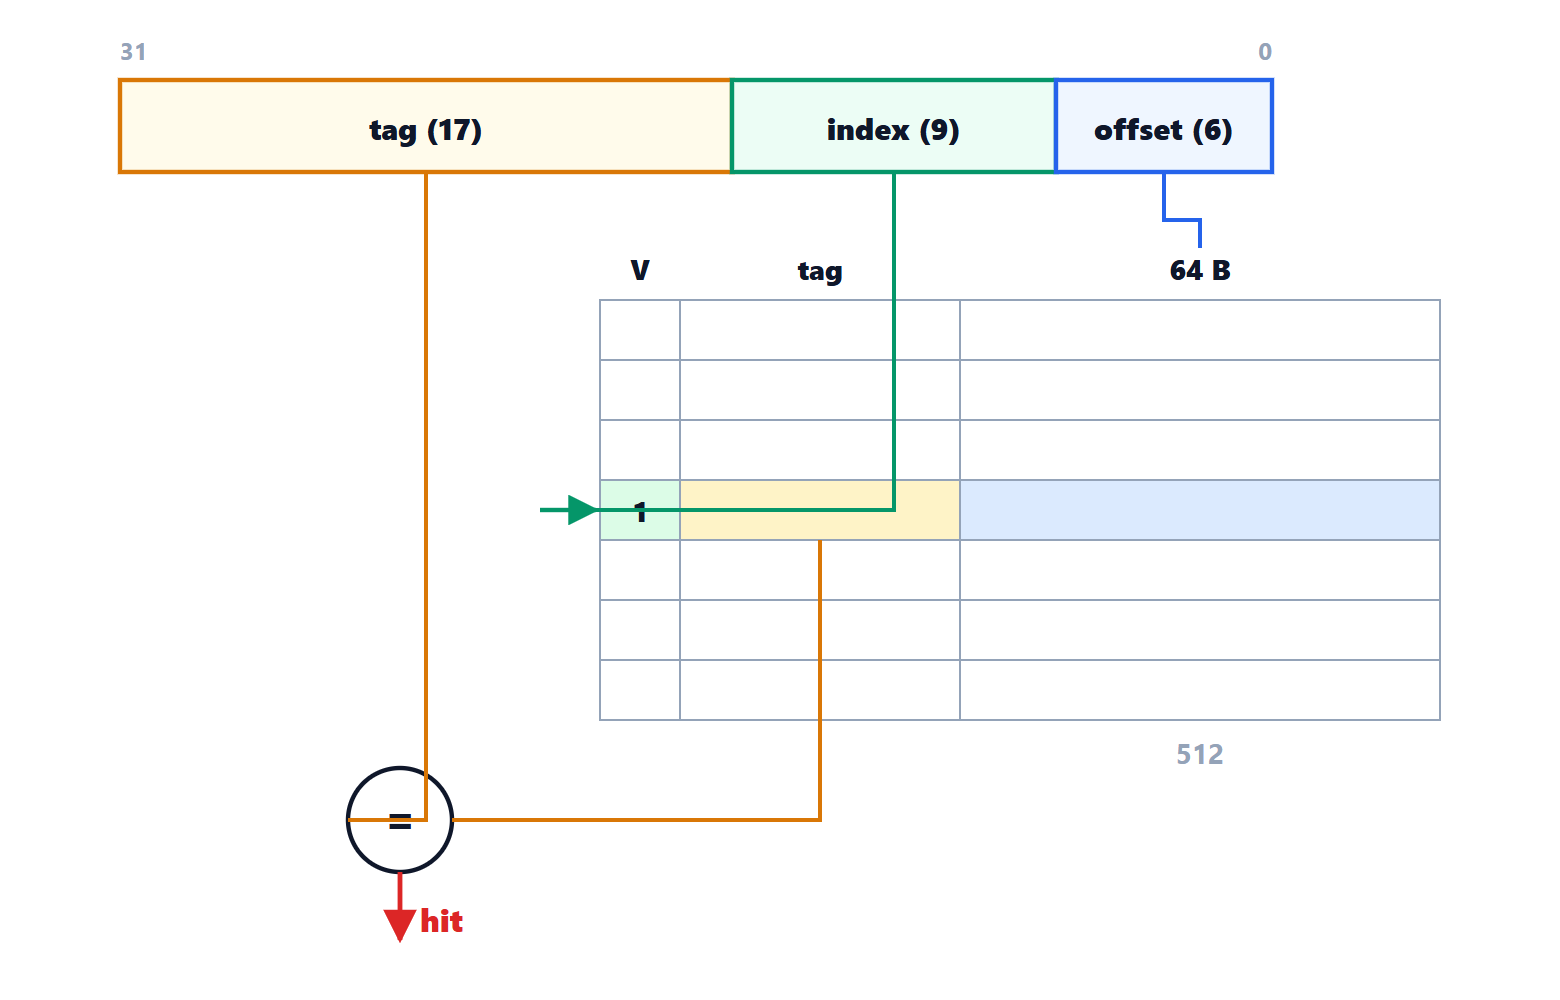
Ogni riga contiene il blocco, l’etichetta e un bit di validità. All’accesso, l’indice sceglie la riga e si confronta l’etichetta: se coincide (e la riga è valida) è un successo (hit), altrimenti un fallimento (miss): il blocco si legge dal livello inferiore e sostituisce quello presente.
Il tempo medio di accesso
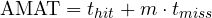
dove  è la frequenza dei fallimenti e
 il tempo per recuperare il blocco.
Esempio. Cache da 1 ciclo, 5% di fallimenti, 100 cicli per andare in DRAM: AMAT = 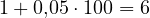 cicli. Aggiungendo una cache di secondo livello da 10 cicli, che trova l’80% dei blocchi mancanti nel primo livello: AMAT =
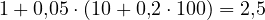 cicli. Il secondo livello più che dimezza il tempo medio.
Anche percentuali di fallimento che sembrano piccole pesano molto: passare dal 2% al 4% di fallimenti, con 100 cicli di penalità, porta l’AMAT da 3 a 5 cicli.
Associatività e tipi di fallimento
Nella corrispondenza diretta due blocchi usati alternativamente che finiscono nella stessa riga si cacciano a vicenda. Le cache associative a  vie permettono a ogni blocco di stare in righe diverse (un insieme), confrontando etichette in parallelo, e quando l’insieme è pieno sostituiscono il blocco usato meno di recente (LRU). Le cache di primo livello sono tipicamente a 8 vie.
I fallimenti si classificano nelle “tre C”: obbligatori (compulsory, il primo accesso a un blocco), di capacità (i dati usati non ci stanno tutti), di conflitto (blocchi che si contendono lo stesso insieme).
Le scritture. Con la politica write-through ogni scrittura va anche nel livello inferiore; con la write-back si scrive solo in cache, e il blocco modificato (segnato con un bit “sporco”) viene copiato in memoria quando viene sostituito. La seconda riduce molto il traffico verso la memoria ed è quella usata dalle cache dei processori.
Il codice conta
In C le matrici sono memorizzate per righe: gli elementi di una riga sono contigui.
/* veloce: scorre la memoria in ordine */
for (i = 0; i < N; i++)
    for (j = 0; j < N; j++)
        s += a[i][j];

/* lento: salta di N elementi a ogni accesso */
for (j = 0; j < N; j++)
    for (i = 0; i < N; i++)
        s += a[i][j];
Le due versioni fanno esattamente gli stessi calcoli, ma con una matrice di grandi dimensioni la seconda può essere diverse volte più lenta: ogni accesso cade in un blocco diverso, e quando si torna sulla stessa riga il blocco è già stato sostituito. Organizzare i dati e i cicli in modo da sfruttare la località è una delle ottimizzazioni più efficaci in assoluto, e la base delle librerie numeriche veloci (che lavorano a blocchi che stanno in cache).