Struct, liste concatenate e strutture dati
Struct e typedef, operatore freccia, liste concatenate con inserimento e scorrimento, confronto con gli array, pile, code, alberi e tabelle hash.
Un array raccoglie dati dello stesso tipo. Ma spesso un’informazione è fatta di dati diversi che vanno tenuti insieme: un componente ha un codice, un valore, una tolleranza e una quantità in magazzino. Le struct del C raggruppano campi di tipo diverso in un unico tipo nuovo. Con le struct e i puntatori si costruiscono le strutture dati dinamiche, la prima delle quali è la lista concatenata. In questa lezione vediamo entrambe, con i vantaggi e gli svantaggi rispetto agli array.
Le struct
#include <stdio.h>

struct componente {
    char   codice[16];
    double valore;        /* in ohm, farad o henry */
    double tolleranza;    /* in percentuale */
    int    quantita;
};

int main(void)
{
    struct componente r = {"R-10K", 10e3, 1.0, 250};
    r.quantita -= 10;                                     /* accesso ai campi con il punto */
    printf("%s: %.0f ohm +/- %.0f%%, %d pezzi\n", r.codice, r.valore, r.tolleranza, r.quantita);
    return 0;
}
Con typedef si dà al tipo un nome più corto: typedef struct componente Componente;. Le struct si possono copiare con l’assegnamento, passare alle funzioni e mettere in array: Componente magazzino[500]; è un piccolo database.
Una struct grande passata per valore viene copiata tutta. Di solito si passa il suo indirizzo, e si accede ai campi con l’operatore freccia: p->valore è un’abbreviazione di (*p).valore.
double valore_minimo(const Componente *c)
{
    return c->valore * (1.0 - c->tolleranza / 100.0);
}
La lista concatenata
Un array ha due limiti: la dimensione è fissa, e inserire un elemento in mezzo richiede di spostare tutti quelli dopo,  . Una lista concatenata risolve entrambi: ogni elemento (nodo) contiene il dato e un puntatore al nodo successivo; l’ultimo punta a
NULL.
typedef struct nodo {
    int valore;
    struct nodo *succ;
} Nodo;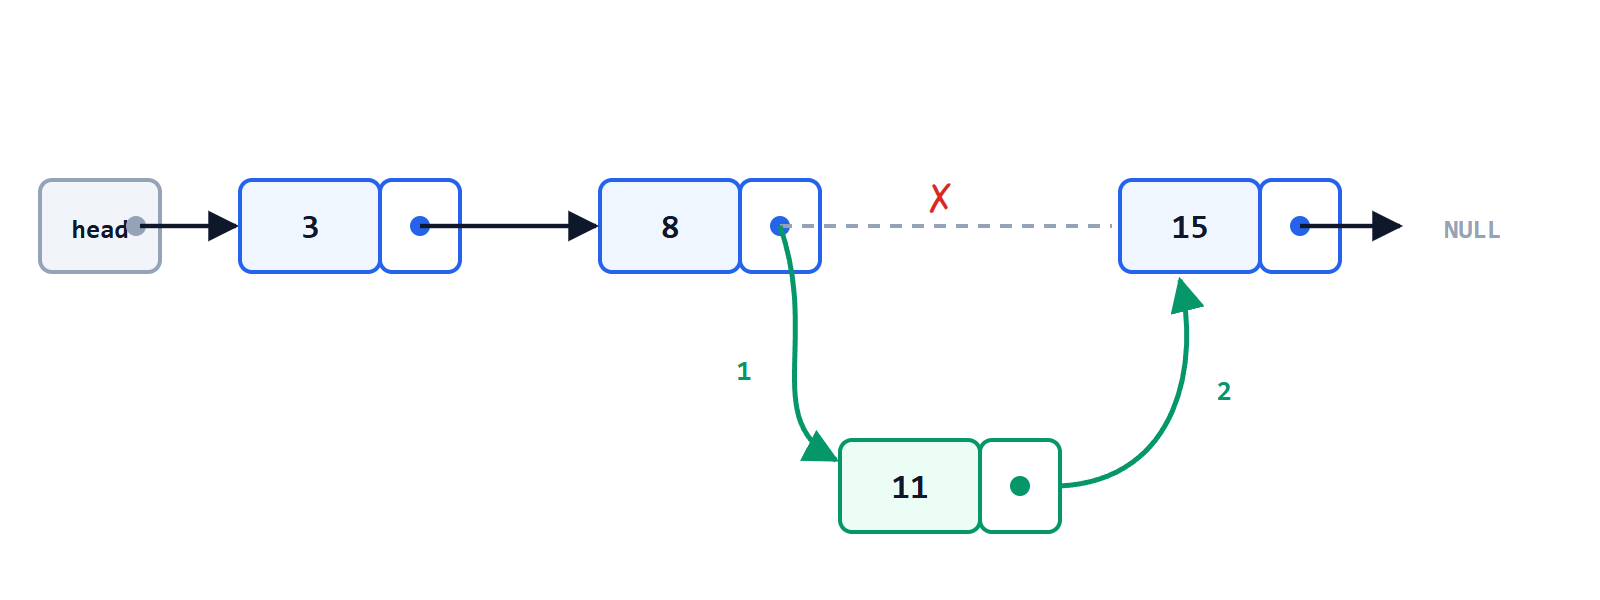
Inserimento e scorrimento
#include <stdlib.h>

/* inserisce v dopo il nodo prec; restituisce il nuovo nodo o NULL */
Nodo *inserisci_dopo(Nodo *prec, int v)
{
    Nodo *n = malloc(sizeof *n);
    if (n == NULL) return NULL;
    n->valore = v;
    n->succ = prec->succ;      /* 1: il nuovo nodo punta al successivo */
    prec->succ = n;            /* 2: il precedente punta al nuovo nodo */
    return n;
}

void stampa(const Nodo *head)
{
    for (const Nodo *p = head; p != NULL; p = p->succ) {
        printf("%d ", p->valore);
    }
    printf("\n");
}
L’ordine dei due assegnamenti conta: facendoli al contrario si perde il riferimento al resto della lista. Togliere un nodo è altrettanto rapido: il precedente passa a puntare al successivo, e il nodo tolto si libera con free.
Array o lista?
| Operazione | Array | Lista concatenata |
|---|---|---|
| accesso all’elemento i-esimo |  | : bisogna scorrere |
| inserimento o rimozione in mezzo (avendo la posizione) | : spostamenti | |
| crescita | dimensione fissa o riallocazione | un nodo alla volta |
| memoria in più | nessuna | un puntatore per nodo |
| uso della cache | ottimo, celle contigue | scarso, nodi sparsi |
Nella pratica, sui processori moderni, gli array sono spesso più veloci anche quando la teoria favorisce le liste, proprio per la cache. Le liste servono quando gli inserimenti e le rimozioni in posizioni note sono frequenti, o quando gli elementi devono restare allo stesso indirizzo.
Pile, code e altre strutture
Con array e liste si costruiscono le strutture dati fondamentali:
- pila (stack): l’ultimo inserito è il primo a uscire (LIFO). È la pila delle chiamate a funzione, e quella che usa una calcolatrice in notazione polacca inversa.
- coda (queue): il primo inserito è il primo a uscire (FIFO). È il buffer circolare che riceve i byte di una porta seriale: l’interruzione di ricezione li mette in coda, il programma principale li legge con calma.
- alberi: ogni nodo ha più successori. Gli alberi binari di ricerca trovano un elemento in
 passi, e i file system organizzano cartelle e file ad albero.
- tabelle hash: trovano un elemento a partire dalla sua chiave in tempo medio , calcolando direttamente la posizione con una funzione della chiave. Sono i “dizionari” di Python e gli oggetti di JavaScript.
Scegliere la struttura dati giusta è metà del lavoro di progettazione di un programma: come diceva Niklaus Wirth, algoritmi più strutture dati uguale programmi.