Algoritmi di ordinamento: inserimento, merge sort e quicksort
Ordinamento a bolle e per inserimento, merge sort con codice e analisi del costo, quicksort e qsort, limite teorico n log n, counting sort e tabella di confronto.
Ordinare dei dati è una delle operazioni più frequenti: una classifica, un elenco di componenti per prezzo, i campioni per calcolare la mediana, i dati prima di una ricerca binaria. Ed è il terreno su cui si vede meglio quanto conta la complessità di un algoritmo: con un milione di elementi, un buon algoritmo impiega un decimo di secondo, uno ingenuo ore. In questa lezione vediamo gli ordinamenti elementari, il merge sort e il quicksort, e il limite teorico oltre il quale non si può andare.
Ordinamento a bolle e per inserimento
A bolle (bubble sort): si scorre l’array scambiando le coppie vicine in ordine sbagliato; dopo ogni passata l’elemento più grande è arrivato in fondo, come una bolla che sale. Servono fino a  passate di
 confronti:
 .
Per inserimento (insertion sort): si costruisce la parte ordinata un elemento alla volta, inserendo ogni nuovo elemento al suo posto tra quelli già ordinati, come si sistemano le carte in mano.
void insertion_sort(int v[], int n)
{
    for (int i = 1; i < n; i++) {
        int x = v[i];
        int j = i - 1;
        while (j >= 0 && v[j] > x) {   /* sposta a destra i più grandi */
            v[j + 1] = v[j];
            j--;
        }
        v[j + 1] = x;
    }
}
Anche questo è nel caso peggiore, ma su dati quasi ordinati è velocissimo, quasi  , e con pochi elementi (fino a qualche decina) batte gli algoritmi più sofisticati. Per questo le librerie lo usano per i pezzi piccoli.
Merge sort: dividi e conquista
L’idea è ricorsiva:
- si divide l’array in due metà;
- si ordina ciascuna metà (ricorsivamente);
- si fondono le due metà ordinate in un’unica sequenza ordinata.
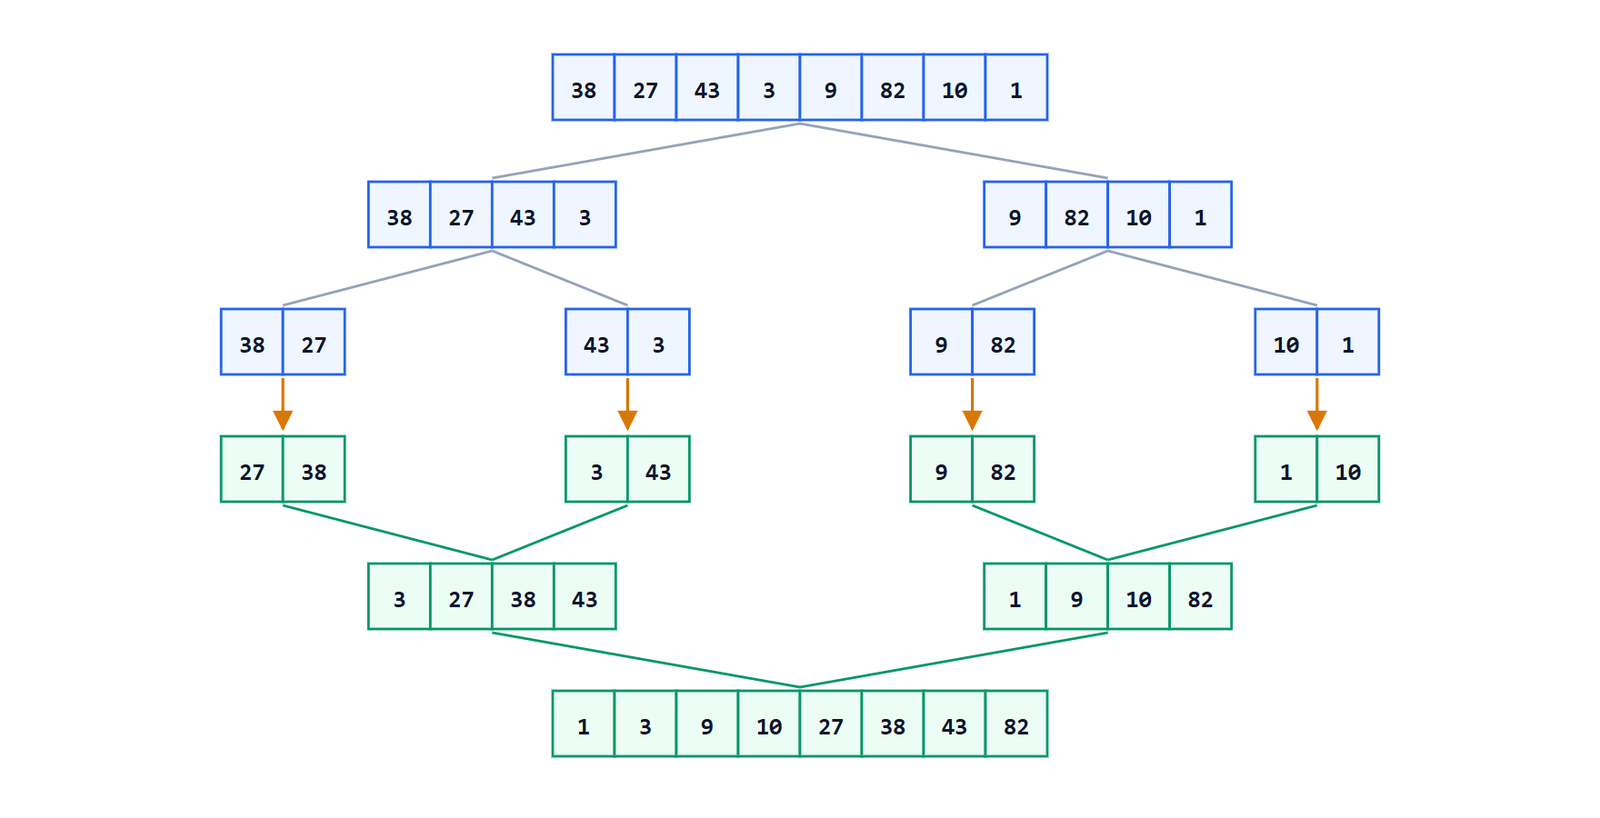
La fusione di due sequenze ordinate è facile: si confrontano i primi elementi e si prende il più piccolo, finché una delle due finisce.
#include <string.h>

/* fonde v[lo..mid-1] e v[mid..hi-1], già ordinati, usando tmp come appoggio */
static void merge(int v[], int tmp[], int lo, int mid, int hi)
{
    int i = lo, j = mid, k = lo;
    while (i < mid && j < hi) tmp[k++] = (v[i] <= v[j]) ? v[i++] : v[j++];
    while (i < mid) tmp[k++] = v[i++];
    while (j < hi)  tmp[k++] = v[j++];
    memcpy(v + lo, tmp + lo, (hi - lo) * sizeof v[0]);
}

void merge_sort(int v[], int tmp[], int lo, int hi)   /* ordina v[lo..hi-1] */
{
    if (hi - lo < 2) return;
    int mid = lo + (hi - lo) / 2;
    merge_sort(v, tmp, lo, mid);
    merge_sort(v, tmp, mid, hi);
    merge(v, tmp, lo, mid, hi);
}
Perché costa 
A ogni livello della ricorsione le fusioni elaborano in totale tutti gli elementi, e i livelli sono  , perché a ogni livello le parti si dimezzano. Quindi il lavoro totale è proporzionale a
 . Con
 : circa
 operazioni contro le
 del bubble sort. Il merge sort è anche stabile (elementi uguali mantengono l’ordine originale), ma richiede un array di appoggio grande quanto quello da ordinare.
Quicksort
Si sceglie un elemento, il pivot, e si riorganizza l’array in modo che i più piccoli stiano a sinistra e i più grandi a destra; poi si ordinano ricorsivamente le due parti. Non serve memoria aggiuntiva e, in media, è il più veloce nella pratica, . Ma se il pivot è sempre il più piccolo o il più grande (per esempio scegliendo il primo elemento di un array già ordinato), le parti sono sbilanciate e il costo diventa . Le implementazioni serie scelgono il pivot a caso o come mediana di tre elementi. La funzione qsort della libreria standard del C lo usa spesso, con un puntatore alla funzione di confronto:
#include <stdlib.h>

static int confronta(const void *a, const void *b)
{
    int x = *(const int *)a, y = *(const int *)b;
    return (x > y) - (x < y);      /* -1, 0, 1 senza rischio di overflow */
}

/* ... */
qsort(v, n, sizeof v[0], confronta);
Il limite teorico
Un algoritmo che ordina solo confrontando coppie di elementi deve distinguere tra tutte le  permutazioni possibili, e ogni confronto ha due esiti: servono almeno
 confronti nel caso peggiore. Per la formula di Stirling
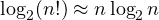 . Quindi nessun ordinamento per confronti può fare meglio di : merge sort è ottimo.
Il limite si aggira solo sfruttando la struttura dei dati. Il counting sort ordina interi compresi tra 0 e  contando quante volte compare ogni valore, in
 : è il modo più rapido di calcolare l’istogramma e la mediana delle letture di un convertitore a 12 bit (
 ).
Quale scegliere
| Algoritmo | Caso medio | Caso peggiore | Memoria in più | Stabile |
|---|---|---|---|---|
| inserimento | | |  | sì |
| merge sort | | | | sì |
| quicksort | | |  | no |
| heapsort | | | | no |
Nella pratica si usa quasi sempre la funzione di libreria. Su un microcontrollore, con pochi elementi e poca memoria, l’ordinamento per inserimento è spesso la scelta migliore: semplice, senza ricorsione e senza memoria aggiuntiva.