Poursuite radar : précision de mesure et borne de Cramér-Rao, filtres α-β et de Kalman, IMM et association
Résolution et précision, la borne de Cramér-Rao vérifiée par une simulation, le radar de poursuite classique et le monopulse, les filtres α-β et de Kalman avec le compromis entre bruit et réactivité, le filtre IMM, le filtrage de fenêtre (gating) et le GNN, l'association JPDA et MHT.
https://www.electronics-engineering.com/fr/poursuite-radar-cramer-rao-alpha-beta-kalman-imm-association-de-donnees/
Trouver une cible ne suffit pas : un radar de contrôle du trafic aérien, un radar naval ou un radar d’automobile doit la suivre dans le temps, estimer sa position et sa vitesse mieux que ne le dit chaque mesure prise isolément, prévoir où elle sera et reconnaître quand elle manœuvre. C’est la poursuite (tracking). Cette leçon part de la précision avec laquelle le radar mesure la distance, l’angle et la vitesse (estimation de paramètres, avec la borne de Cramér-Rao), passe par le radar de poursuite classique, qui suit une cible unique avec l’antenne, et arrive aux filtres utilisés aujourd’hui dans tous les systèmes : le filtre α-β, le filtre de Kalman, l’association entre mesures et pistes quand il y a de nombreuses cibles, et les filtres à modèles multiples pour les manœuvres. Une simulation montre le compromis fondamental entre bruit et réactivité.
L’idée en mots simples
Suivre une cible avec un radar, c’est comme suivre une balle des yeux pendant un match regardé à travers une vitre sale : parfois on la voit nettement, parfois elle apparaît déplacée, mais le cerveau ne saute pas derrière chaque image ; il imagine où la balle devrait être (parce qu’il sait qu’elle se déplace à une certaine vitesse) et corrige un peu cette idée avec ce qu’il voit. Si la balle change brusquement de direction, pendant un instant le cerveau « est en retard », puis il rattrape.
Un filtre de poursuite fait la même chose avec des formules : il prédit où sera la cible, il mesure, et il corrige la prédiction avec une partie de l’écart. De combien corriger est le choix clé : corriger peu donne une piste lisse mais lente à suivre les manœuvres, corriger beaucoup donne une piste réactive mais tremblante. Le filtre de Kalman calcule la meilleure correction en sachant quelle est la précision des mesures (la première partie de la leçon) et à quel point la cible est imprévisible.
Un peu d’histoire
Le radar est associé aux micro-ondes, mais les premiers systèmes de mesure de distance par écho furent les sondages en ondes courtes (HF) utilisés dans les années 1920 par Breit et Tuve pour mesurer la hauteur de l’ionosphère. Les premiers radars opérationnels, le réseau Chain Home construit par les Britanniques à la fin des années 1930 pour détecter les avions ennemis puis les missiles V-2, travaillaient eux aussi dans la partie haute de la bande des ondes courtes (longueurs d’onde d’une dizaine de mètres), parce que la technologie de l’époque ne permettait pas de fréquences plus élevées : en un sens, ils étaient les ancêtres des radars transhorizon (OTH). Le magnétron à cavités (1940) a amené le radar aux micro-ondes, avec de petites antennes et des faisceaux étroits, et a rendu possibles les radars de conduite de tir et de poursuite.
Le radar de poursuite classique
Un radar de poursuite garde la cible au centre du faisceau avec des servomécanismes :
- en distance, avec une porte de distance divisée en deux moitiés, avancée et retardée : si l’écho tombe davantage dans la moitié retardée, la porte avance (porte avance-retard) ;
- en angle, avec le balayage conique (le faisceau tourne autour de l’axe et l’écho est modulé en amplitude si la cible est décentrée) ou, bien mieux, avec le monopulse de la leçon sur les réseaux d’antennes à commande de phase, qui mesure l’erreur avec une seule impulsion et est insensible aux fluctuations d’amplitude (un brouilleur qui module sa puissance à la fréquence de balayage trompe facilement le balayage conique).
Les radars modernes à réseau, eux, suivent de nombreuses cibles en « temps partagé » : le faisceau saute d’une cible à l’autre, et la continuité est assurée par le filtre de poursuite, qui est le sujet du reste de la leçon. Il en va de même pour les radars de surveillance (une mesure par tour d’antenne) et les radars d’automobile (une mesure environ toutes les 50 ms).
La précision de mesure : l’estimation de paramètres
Avant de filtrer les mesures, il faut savoir quelle est leur précision. Il ne faut pas confondre résolution et précision : la résolution ( en distance, la largeur du faisceau en angle,
 en vitesse) dit à quelle distance l’une de l’autre doivent se trouver deux cibles pour être vues comme séparées ; la précision dit avec quelle erreur on mesure la position d’une cible isolée. Avec un bon rapport signal sur bruit, la précision est bien meilleure que la résolution, parce que le centre d’un pic large peut être localisé avec une petite erreur, comme on lit un thermomètre entre deux graduations.
La borne de Cramér-Rao. La statistique donne une borne inférieure de l’erreur de tout estimateur non biaisé : pour le retard  d’un écho dans un bruit blanc,
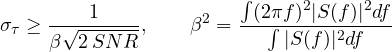
où  est le rapport signal sur bruit de crête après le filtre adapté et
 la largeur de bande efficace (rms) du signal. Pour un spectre plat de largeur
 ,
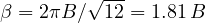 , et en distance
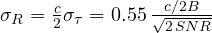 . La règle empirique des manuels,
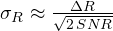 , a la même forme avec une constante qui dépend du spectre. Le message est clair : la précision s’améliore comme la racine carrée du rapport signal sur bruit et proportionnellement à la bande.
De même, pour l’angle (avec le monopulse), 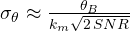 , avec
 la pente du monopulse ; pour la vitesse,
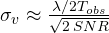 .
Simulation. Un écho de 1 MHz de bande (résolution de 150 m), estimé avec le filtre adapté et une recherche fine du pic, 1000 essais pour chaque niveau :
| SNR | erreur simulée | borne de Cramér-Rao | règle empirique |
|---|---|---|---|
| 30 dB | 1,8 m | 1,8 m | 3,4 m |
| 20 dB | 5,6 m | 5,8 m | 10,6 m |
| 10 dB | 19,8 m (plus 7,8 % d’erreurs grossières) | 18,2 m | 33,5 m |
À fort SNR, l’estimateur atteint la borne théorique (la petite différence sous la borne à 20 dB tient au nombre fini d’essais, qui donne une incertitude de quelques pour cent sur l’écart-type estimé) : à 20 dB, l’erreur est de 5,6 m, presque trente fois plus petite que la résolution. À faible SNR apparaît l’effet de seuil : parfois le bruit fait gagner un lobe secondaire et l’erreur devient grossière (des centaines de mètres). Pour l’angle, avec un faisceau de 2° et 20 dB,  : à 50 km, cela fait 77 m d’erreur transversale, bien plus que les 6 m en distance. Pour la vitesse, avec 64 ms d’observation en bande X, la résolution est de 0,23 m/s et la précision de 1,7 cm/s. Ce sont les valeurs de
 à mettre dans le modèle de mesure du filtre de Kalman, et elles expliquent pourquoi l’incertitude d’une piste est une ellipse allongée dans la direction transversale.
import numpy as np

# range measurement accuracy: simulation against the Cramér-Rao bound
c, B = 299792458.0, 1e6                                # 1 MHz bandwidth: resolution c/2B = 150 m
N, fs = 256, 4e6                                       # samples in the frequency domain, sampling rate
f = np.fft.fftfreq(N, 1 / fs)
S = (np.abs(f) <= B / 2).astype(float)                 # flat spectrum B wide
E = np.sum(S ** 2)
rng = np.random.default_rng(0)
true_delay = 10.3 / fs                                 # echo at 10.3 samples: not on a sample
for snr_dB in (10, 20, 30):
    snr = 10 ** (snr_dB / 10)                          # peak signal-to-noise ratio after the matched filter
    sig_n = np.sqrt(E / snr)                           # noise per complex component in frequency
    errors = []
    grid = np.linspace(-0.6, 0.6, 601) / fs            # fine search around the coarse peak
    for _ in range(1000):
        R = S * np.exp(-2j * np.pi * f * true_delay) + sig_n * (rng.normal(size=N) + 1j * rng.normal(size=N)) / np.sqrt(2)
        Y = R * S                                      # matched filter in the frequency domain
        t0 = np.argmax(np.abs(np.fft.ifft(Y))) / fs
        tt = t0 + grid
        out = np.abs(np.exp(2j * np.pi * np.outer(tt, f)) @ Y)
        errors.append(tt[np.argmax(out)] - true_delay)
    err = np.array(errors) * c / 2
    gross = np.abs(err) > c / (2 * B)                  # the peak landed on a wrong lobe
    beta = np.sqrt(np.sum((2 * np.pi * f) ** 2 * S ** 2) / E)     # effective (rms) bandwidth
    crb = c / 2 / (beta * np.sqrt(2 * snr))
    print(f"SNR {snr_dB} dB: simulated error {np.std(err[~gross]):5.1f} m ({gross.mean() * 100:.1f} % gross errors), "
          f"Cramér-Rao {crb:5.1f} m, rule of thumb c/2B/sqrt(2 SNR) {c / (2 * B) / np.sqrt(2 * snr):5.1f} m")

# angle and velocity accuracy with the approximate formulas
snr = 100.0
print(f"angle: 2 degree beam, km = 1.6, SNR 20 dB: {2 / (1.6 * np.sqrt(2 * snr)):.3f} degrees, that is {50e3 * np.radians(2 / (1.6 * np.sqrt(2 * snr))):.0f} m at 50 km")
lam, Tobs = 0.03, 64e-3
print(f"velocity: resolution {lam / (2 * Tobs):.3f} m/s, accuracy with SNR 20 dB {lam / (2 * Tobs) / np.sqrt(2 * snr):.4f} m/s")
Le filtre α-β
La cible se déplace à vitesse à peu près constante ; à chaque mesure  (de période
 ), le filtre prédit où elle devrait être puis corrige la prédiction avec une fraction de l’erreur (l’innovation
 ) :
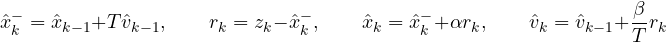
Avec de petits  et , le filtre « fait confiance » à la prédiction et moyenne beaucoup de mesures (peu de bruit, mais réponse lente à une manœuvre) ; avec de grandes valeurs, il suit les mesures (réactif, mais bruité). Un choix classique qui lie les deux paramètres est celui de Benedict et Bordner,
 .
Le filtre de Kalman
Le filtre de Kalman (1960) généralise l’α-β : il décrit la cible par un modèle d’état 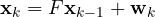 (par exemple position et vitesse, avec une accélération aléatoire
 de covariance
 ) et la mesure par
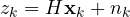 (bruit de variance
 ), et il calcule à chaque pas le gain optimal à partir de l’incertitude
 de l’estimation :
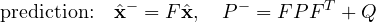
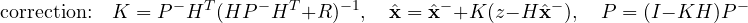
Pour un système linéaire à bruits gaussiens, c’est l’estimateur de variance minimale (sa démonstration se trouve dans l’article sur le filtre de Kalman lié à cette leçon). Après quelques pas, et  se stabilisent : le filtre de Kalman en régime permanent est un filtre α-β, avec et fixés par le rapport entre le bruit de processus et le bruit de mesure . L’avantage du filtre de Kalman est qu’il fonctionne bien aussi dans le régime transitoire initial, avec des périodes de mesure variables, avec des mesures de natures différentes (distance, angles, Doppler) et en plusieurs dimensions.
La simulation : bruit contre réactivité
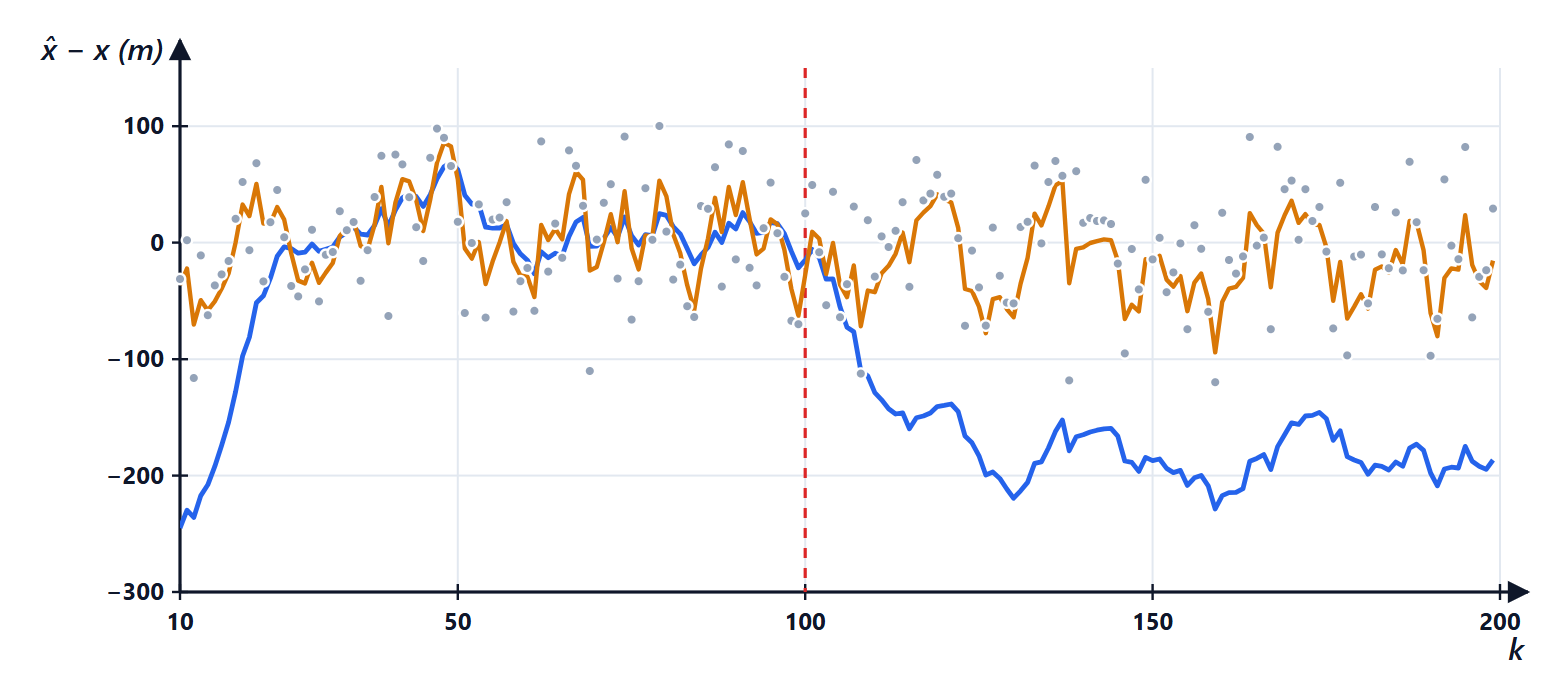
Une cible à 100 m/s, mesurée une fois par seconde avec une erreur de 50 m, qui, après 100 secondes, se met à accélérer à 5 m/s². Erreur rms des estimations (les mesures seules en ont 48 m) :
| filtre | mouvement uniforme | en manœuvre |
|---|---|---|
| α-β avec α = 0,2 | 25 m | 181 m |
| α-β avec α = 0,5 | 33 m | 37 m |
| Kalman avec q = 0,1 | 16 m | 696 m |
| Kalman avec q = 10 | 26 m | 73 m |
Aucun filtre fixe ne fonctionne bien dans les deux situations : celui qui filtre bien le mouvement uniforme perd la cible en manœuvre, celui qui est prêt pour les manœuvres est bruité. Le filtre de Kalman avec  atteint le régime permanent avec
 et
 , pratiquement le couple de Benedict-Bordner (
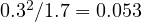 ).
La solution : plusieurs modèles ensemble. Le filtre IMM (interacting multiple model) fait tourner en parallèle plusieurs filtres de Kalman, par exemple un pour le mouvement uniforme et un pour les manœuvres, et les combine pondérés par la probabilité que chaque modèle soit le bon, calculée à partir des innovations. Quand la cible manœuvre, l’innovation du filtre « uniforme » croît, son poids chute et le filtre « manœuvre » l’emporte. C’est le standard dans les systèmes de surveillance aérienne et les radars d’automobile.
De nombreuses cibles : initialisation et association
Avec de nombreuses cibles et de fausses alarmes, il faut décider quelle mesure appartient à quelle piste :
- filtrage de fenêtre (gating) : seules les mesures assez proches de la prédiction sont prises en compte pour une piste, en mesurant la distance avec l’incertitude (distance de Mahalanobis
 , comparée à un seuil de la distribution du khi-deux) ;
- association : avec la règle du plus proche voisin global (GNN, affectation optimale avec l’algorithme hongrois), ou avec des méthodes probabilistes qui pondèrent toutes les mesures compatibles (JPDA), ou en gardant plusieurs hypothèses alternatives jusqu’à ce que les données les départagent (MHT) ;
- initialisation et suppression : une nouvelle piste naît de mesures non associées et est confirmée si elle réapparaît, par exemple, dans 3 balayages sur 5 (logique M sur N) ; une piste sans mesures pendant trop de balayages est supprimée.
Les mêmes outils servent à assembler des objets à partir des points d’un radar d’automobile, dans la leçon dédiée.
Résumé
- Résolution et précision sont deux choses différentes : la précision s’améliore comme la racine carrée du rapport signal sur bruit et atteint la borne de Cramér-Rao.
- En angle, l’erreur transversale croît avec la distance : l’incertitude d’une piste est une ellipse allongée.
- Le filtre α-β prédit et corrige avec des gains fixes ; le filtre de Kalman calcule les gains optimaux, et en régime permanent il coïncide avec un α-β.
- Aucun filtre fixe ne fonctionne à la fois en mouvement uniforme et en manœuvre : l’IMM combine plusieurs modèles.
- Avec de nombreuses cibles, il faut le filtrage de fenêtre, l’association (GNN, JPDA, MHT) et une logique de confirmation des pistes.
Le code
import numpy as np

rng = np.random.default_rng(0)
T, steps, sigma = 1.0, 200, 50.0                     # one measurement per second, 50 m measurement error
k = np.arange(steps)
true = 1000 + 100 * k * T + 0.5 * 5.0 * (np.maximum(k - 100, 0) * T) ** 2   # 100 m/s, then accelerates at 5 m/s^2
z = true + rng.normal(0, sigma, steps)               # range measurements

def alpha_beta(alpha):
    beta = alpha ** 2 / (2 - alpha)                  # Benedict-Bordner choice
    x, v, estimates = z[0], 0.0, []
    for zk in z:
        xp = x + v * T                               # prediction
        r = zk - xp                                  # innovation: measurement minus prediction
        x, v = xp + alpha * r, v + beta / T * r      # correction
        estimates.append(x)
    return np.array(estimates), beta

def kalman(q):
    F = np.array([[1, T], [0, 1]]); H = np.array([[1.0, 0.0]])
    Q = q * np.array([[T ** 4 / 4, T ** 3 / 2], [T ** 3 / 2, T ** 2]])   # random acceleration of variance q
    R = np.array([[sigma ** 2]])
    x, P, estimates, gains = np.array([z[0], 0.0]), np.diag([sigma ** 2, 1e4]), [], []
    for zk in z:
        x, P = F @ x, F @ P @ F.T + Q                # prediction
        S = H @ P @ H.T + R
        K = P @ H.T / S                              # Kalman gain
        x = x + (K * (zk - H @ x)).ravel()
        P = (np.eye(2) - K @ H) @ P
        estimates.append(x[0]); gains.append(K.ravel())
    return np.array(estimates), gains[-1]

def rms(s, a, b):
    return np.sqrt(np.mean((s - true)[a:b] ** 2))

for alpha in (0.2, 0.5):
    s, beta = alpha_beta(alpha)
    print(f"alpha-beta alpha = {alpha}, beta = {beta:.3f}: error {rms(s, 20, 100):5.1f} m in uniform motion, {rms(s, 110, 200):6.1f} m manoeuvring")
for q in (0.1, 10.0):
    s, K = kalman(q)
    print(f"Kalman q = {q:4}: error {rms(s, 20, 100):5.1f} m and {rms(s, 110, 200):6.1f} m; steady-state gains alpha = {K[0]:.3f}, beta = {K[1] * T:.3f}")
print(f"error of the measurements alone: {np.sqrt(np.mean((z - true) ** 2)):.1f} m")
L’exécution du premier programme affiche les lignes du tableau de précision et les précisions en angle et en vitesse (0,088°, 77 m, 0,234 m/s et 0,0166 m/s). Le second affiche les lignes du tableau des filtres : 25,2 et 180,8 m, 33,0 et 36,7 m, 16,3 et 695,6 m avec des gains 0,106 et 0,006, 25,5 et 73,1 m avec des gains 0,299 et 0,053, et 48,1 m pour les mesures seules.




Benvenuti nella pagina su «Inseguimento radar: precisione delle misure e limite di Cramér-Rao, filtri α-β e di Kalman, IMM e associazione». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Radar tracking: measurement accuracy and the Cramér-Rao bound, α-β and Kalman filters, IMM and association”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.