Inseguimento radar: precisione delle misure e limite di Cramér-Rao, filtri α-β e di Kalman, IMM e associazione
Risoluzione e precisione, il limite di Cramér-Rao verificato con una simulazione, il radar di inseguimento classico e il monopulse, i filtri α-β e di Kalman con il compromesso tra rumore e prontezza, il filtro IMM, finestre di convalida e associazione GNN, JPDA e MHT.
https://www.electronics-engineering.com/articolo_147-radar_ad_inseguimento.htm
Trovare un bersaglio non basta: un radar di controllo del traffico aereo, un radar navale o il radar di un’auto devono seguirlo nel tempo, stimarne posizione e velocità meglio di quanto dica ogni singola misura, prevedere dove sarà e riconoscere quando sta manovrando. È l’inseguimento (tracking). Questa lezione parte dalla precisione con cui il radar misura distanza, angolo e velocità (la stima dei parametri, con il limite di Cramér-Rao), passa per il radar di inseguimento classico, che segue un solo bersaglio con l’antenna, e arriva ai filtri usati oggi in tutti i sistemi: il filtro α-β, il filtro di Kalman, l’associazione tra misure e tracce quando i bersagli sono molti, e i filtri a modelli multipli per le manovre. Una simulazione mostra il compromesso fondamentale tra rumore e prontezza.
L’idea in parole semplici
Seguire un bersaglio con il radar è come seguire con lo sguardo un pallone durante una partita vista da una finestra sporca: ogni tanto lo si vede bene, ogni tanto appare spostato, ma il cervello non salta dietro a ogni immagine; immagina dove dovrebbe essere il pallone (perché sa che si muove con una certa velocità) e corregge un po’ questa idea con ciò che vede. Se il pallone cambia direzione all’improvviso, per un attimo il cervello “resta indietro”, poi si riallinea.
Il filtro di inseguimento fa la stessa cosa con le formule: prevede dove sarà il bersaglio, misura, e corregge la previsione con una parte della differenza. Quanto correggere è la scelta chiave: correggendo poco si ottiene una traccia liscia ma lenta a seguire le manovre, correggendo molto una traccia pronta ma nervosa. Il filtro di Kalman calcola la correzione migliore sapendo quanto sono precise le misure (la prima parte della lezione) e quanto è imprevedibile il bersaglio.
Un po’ di storia
Si associa il radar alle microonde, ma i primi sistemi di localizzazione con l’eco furono le sonde in onde corte (HF) usate negli anni Venti da Breit e Tuve per misurare l’altezza della ionosfera. I primi radar operativi, la catena Chain Home installata dagli inglesi alla fine degli anni Trenta per scoprire gli aerei nemici e poi i missili V-2, lavoravano anch’essi nella parte alta delle onde corte (lunghezze d’onda di una decina di metri), perché la tecnologia dell’epoca non permetteva frequenze più alte: in un certo senso furono i progenitori dei radar oltre l’orizzonte (OTH). Il magnetron a cavità (1940) portò il radar alle microonde, con antenne piccole e fasci stretti, e rese possibili i radar di puntamento e di inseguimento.
Il radar di inseguimento classico
Un radar di inseguimento (tracking radar) tiene il bersaglio al centro del fascio con dei servomeccanismi:
- in distanza, con una finestra (range gate) divisa in due metà, anticipata e ritardata: se l’eco cade di più nella metà ritardata, la finestra si sposta in avanti (early-late gate);
- in angolo, con la scansione conica (il fascio ruota intorno all’asse e l’eco viene modulata in ampiezza se il bersaglio non è centrato) o, molto meglio, con il monopulse della lezione sulle schiere di fase, che misura l’errore con un solo impulso ed è insensibile alle fluttuazioni d’ampiezza (un disturbatore che modula la propria potenza alla frequenza di scansione inganna facilmente la scansione conica).
I radar moderni a schiera inseguono invece molti bersagli “a tempo condiviso”: il fascio salta da un bersaglio all’altro, e la continuità la dà il filtro di inseguimento, che è l’oggetto del resto della lezione. Lo stesso vale per i radar di sorveglianza (una misura per giro d’antenna) e per i radar delle auto (una misura ogni 50 ms circa).
La precisione delle misure: la stima dei parametri
Prima di filtrare le misure bisogna sapere quanto sono precise. Attenzione a non confondere risoluzione e precisione: la risoluzione ( in distanza, la larghezza del fascio in angolo,
 in velocità) dice quanto devono essere distanti due bersagli per essere visti separati; la precisione dice con quale errore si misura la posizione di un bersaglio isolato. Con un buon rapporto segnale/rumore la precisione è molto migliore della risoluzione, perché si può localizzare il centro di un picco largo con un errore piccolo, come si legge un termometro tra due tacche.
Il limite di Cramér-Rao. La statistica dà un limite inferiore all’errore di qualunque stimatore senza distorsione: per il ritardo  di un’eco nel rumore bianco,
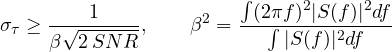
dove  è il rapporto segnale/rumore di picco dopo il filtro adattato e
 la banda efficace (rms) del segnale. Per uno spettro piatto largo
 ,
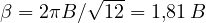 , e in distanza
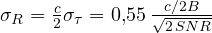 . La regola pratica dei manuali,
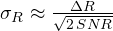 , ha la stessa forma con una costante che dipende dallo spettro. Il messaggio è chiaro: la precisione migliora come la radice del rapporto segnale/rumore e in proporzione alla banda.
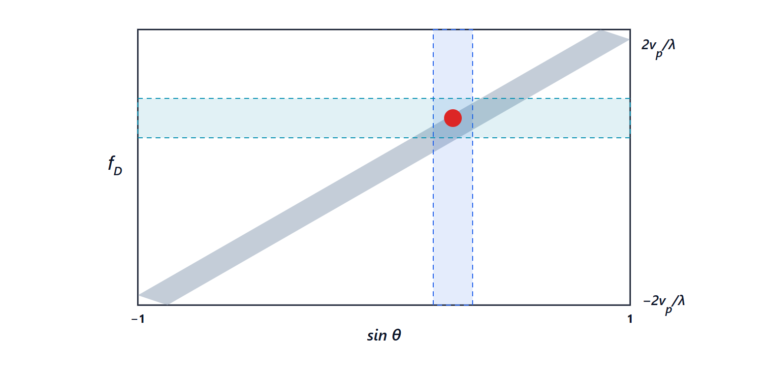
Analogamente, per l’angolo (con il monopulse) 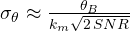 , con
 la pendenza del monopulse; per la velocità
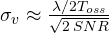 .
Simulazione. Un’eco con 1 MHz di banda (risoluzione 150 m), stimata con il filtro adattato e la ricerca fine del picco, 1000 prove per ogni livello:
| SNR | errore simulato | limite di Cramér-Rao | regola pratica |
|---|---|---|---|
| 30 dB | 1,8 m | 1,8 m | 3,4 m |
| 20 dB | 5,6 m | 5,8 m | 10,6 m |
| 10 dB | 19,8 m (più 7,8 % di errori grossolani) | 18,2 m | 33,5 m |
Con SNR alto lo stimatore raggiunge il limite teorico (la piccola differenza sotto il limite a 20 dB è dovuta al numero finito di prove, che dà un’incertezza di qualche per cento sulla stima della deviazione standard): con 20 dB l’errore è 5,6 m, quasi trenta volte meno della risoluzione. Con SNR basso compare l’effetto soglia: a volte il rumore fa vincere un lobo laterale e l’errore diventa grossolano (centinaia di metri). Per l’angolo, con un fascio di 2° e 20 dB,  : a 50 km sono 77 m di errore trasversale, molto più dei 6 m in distanza. Per la velocità, con 64 ms di osservazione in banda X, la risoluzione è 0,23 m/s e la precisione 1,7 cm/s. Sono questi i valori di
 da mettere nel modello delle misure del filtro di Kalman, e spiegano perché l’incertezza di una traccia è un’ellisse allungata in direzione trasversale.
import numpy as np

# precisione della misura di distanza: simulazione contro il limite di Cramér-Rao
c, B = 299792458.0, 1e6                                # banda 1 MHz: risoluzione c/2B = 150 m
N, fs = 256, 4e6                                       # campioni nel dominio della frequenza, campionamento
f = np.fft.fftfreq(N, 1 / fs)
S = (np.abs(f) <= B / 2).astype(float)                 # spettro piatto largo B
E = np.sum(S ** 2)
rng = np.random.default_rng(0)
ritardo_vero = 10.3 / fs                               # eco a 10,3 campioni: non cade su un campione
for snr_dB in (10, 20, 30):
    snr = 10 ** (snr_dB / 10)                          # rapporto segnale/rumore di picco dopo il filtro adattato
    sig_n = np.sqrt(E / snr)                           # rumore per componente complessa in frequenza
    errori = []
    griglia = np.linspace(-0.6, 0.6, 601) / fs          # ricerca fine intorno al picco grossolano
    for _ in range(1000):
        R = S * np.exp(-2j * np.pi * f * ritardo_vero) + sig_n * (rng.normal(size=N) + 1j * rng.normal(size=N)) / np.sqrt(2)
        Y = R * S                                      # filtro adattato nel dominio della frequenza
        t0 = np.argmax(np.abs(np.fft.ifft(Y))) / fs
        tt = t0 + griglia
        uscita = np.abs(np.exp(2j * np.pi * np.outer(tt, f)) @ Y)
        errori.append(tt[np.argmax(uscita)] - ritardo_vero)
    err = np.array(errori) * c / 2
    grossi = np.abs(err) > c / (2 * B)                 # il picco è finito su un lobo sbagliato
    beta = np.sqrt(np.sum((2 * np.pi * f) ** 2 * S ** 2) / E)     # banda efficace (rms)
    crb = c / 2 / (beta * np.sqrt(2 * snr))
    print(f"SNR {snr_dB} dB: errore simulato {np.std(err[~grossi]):5.1f} m ({grossi.mean() * 100:.1f} % di errori grossolani), "
          f"Cramér-Rao {crb:5.1f} m, regola pratica c/2B/sqrt(2 SNR) {c / (2 * B) / np.sqrt(2 * snr):5.1f} m")

# precisione d'angolo e di velocità con le formule approssimate
snr = 100.0
print(f"angolo: fascio 2 gradi, km = 1,6, SNR 20 dB: {2 / (1.6 * np.sqrt(2 * snr)):.3f} gradi, cioè {50e3 * np.radians(2 / (1.6 * np.sqrt(2 * snr))):.0f} m a 50 km")
lam, Toss = 0.03, 64e-3
print(f"velocità: risoluzione {lam / (2 * Toss):.3f} m/s, precisione con SNR 20 dB {lam / (2 * Toss) / np.sqrt(2 * snr):.4f} m/s")
Il filtro α-β
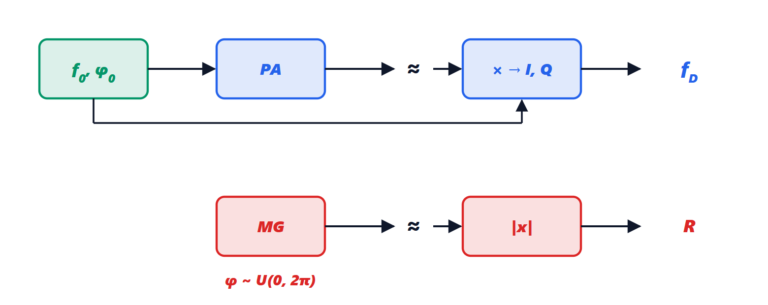
Il bersaglio si muove a velocità circa costante; a ogni misura  (con periodo
 ) il filtro prevede dove dovrebbe essere e poi corregge la previsione con una frazione dell’errore (l’innovazione
 ):
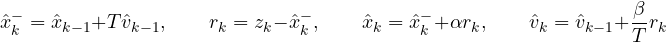
Con  e piccoli il filtro “si fida” della previsione e media molte misure (poco rumore, ma risposta lenta a una manovra); con valori grandi segue le misure (pronto, ma rumoroso). Una scelta classica che lega i due parametri è quella di Benedict e Bordner,
 .
Il filtro di Kalman
Il filtro di Kalman (1960) generalizza l’α-β: descrive il bersaglio con un modello di stato 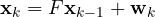 (per esempio posizione e velocità, con un’accelerazione casuale
 di covarianza
 ) e la misura con
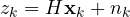 (rumore di varianza
 ), e calcola a ogni passo il guadagno ottimo in base all’incertezza
 della stima:
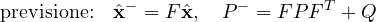
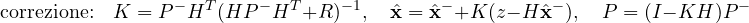
Per un sistema lineare con rumori gaussiani è lo stimatore di minima varianza (la sua derivazione è nell’articolo sul filtro di Kalman collegato a questa lezione). Dopo qualche passo e  si stabilizzano: il filtro di Kalman a regime è un filtro α-β, con e determinati dal rapporto tra il rumore di processo e quello di misura . Il vantaggio del Kalman è che lavora bene anche nel transitorio iniziale, con periodi di misura variabili, con misure di diverso tipo (distanza, angoli, Doppler) e in più dimensioni.
La simulazione: rumore contro prontezza
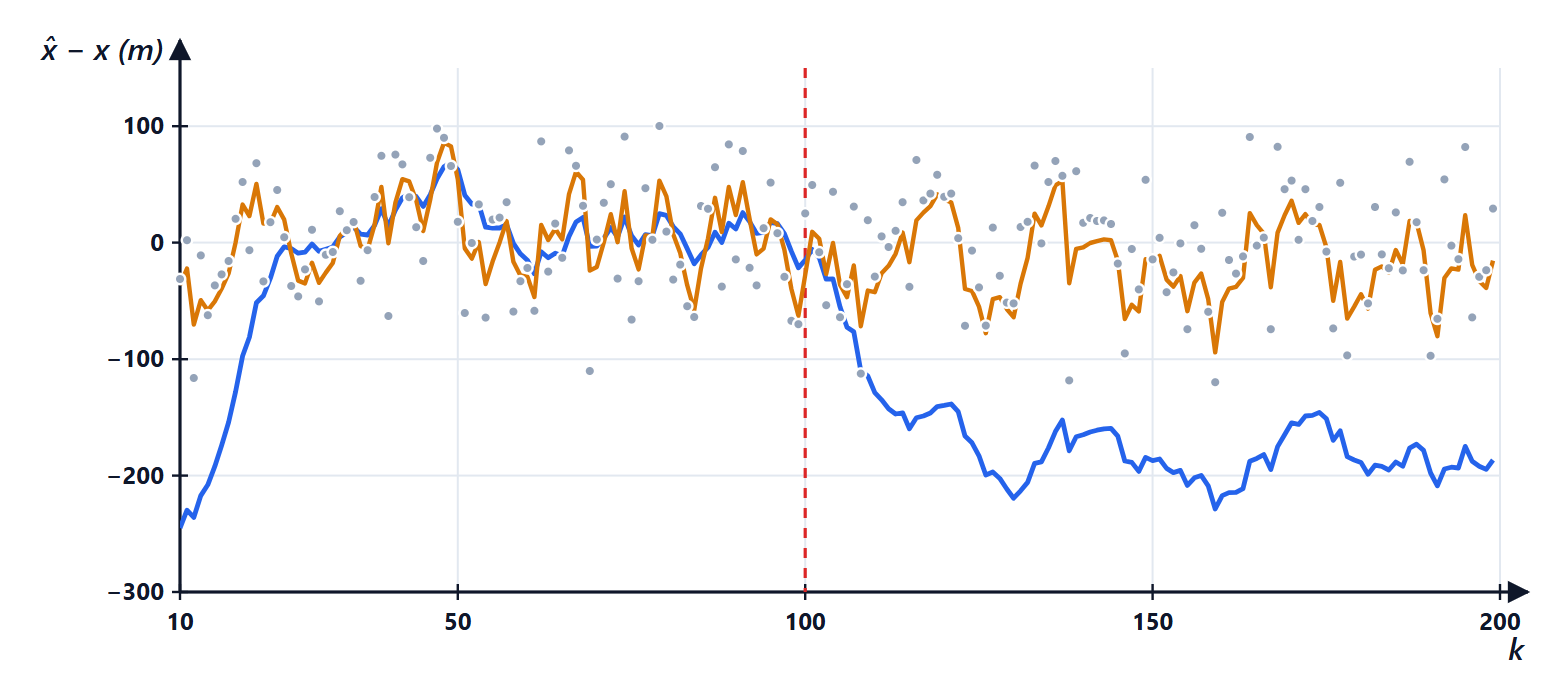
Un bersaglio a 100 m/s, misurato una volta al secondo con un errore di 50 m, che dopo 100 secondi inizia ad accelerare a 5 m/s². Errore efficace delle stime (le misure da sole hanno 48 m):
| filtro | moto uniforme | in manovra |
|---|---|---|
| α-β con α = 0,2 | 25 m | 181 m |
| α-β con α = 0,5 | 33 m | 37 m |
| Kalman con q = 0,1 | 16 m | 696 m |
| Kalman con q = 10 | 26 m | 73 m |
Nessun filtro fisso va bene in entrambe le situazioni: quello che filtra bene il moto uniforme perde il bersaglio in manovra, quello pronto alle manovre è rumoroso. Il Kalman con  arriva a regime con
 e
 , praticamente la coppia di Benedict-Bordner (
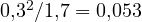 ).
La soluzione: più modelli insieme. Il filtro IMM (interacting multiple model) fa lavorare in parallelo più filtri di Kalman, per esempio uno per il moto uniforme e uno per la manovra, e li combina pesandoli con la probabilità che ciascun modello sia quello giusto, calcolata dalle innovazioni. Quando il bersaglio manovra, l’innovazione del filtro “uniforme” cresce, il suo peso scende e prevale il filtro “manovra”. È lo standard nei sistemi di sorveglianza aerea e nei radar automotive.
Molti bersagli: inizializzazione e associazione
Con molti bersagli e falsi allarmi bisogna decidere quale misura appartiene a quale traccia:
- finestra di convalida (gating): si considerano per una traccia solo le misure abbastanza vicine alla previsione, misurando la distanza con l’incertezza (distanza di Mahalanobis
 , confrontata con una soglia della distribuzione chi quadro);
- associazione: con la regola del vicino più prossimo globale (GNN, assegnazione ottima con l’algoritmo ungherese), oppure con metodi probabilistici che pesano tutte le misure compatibili (JPDA), o mantenendo più ipotesi alternative finché i dati non le risolvono (MHT);
- inizializzazione e cancellazione: una nuova traccia nasce da misure non associate e viene confermata se si ripresenta, per esempio, in 3 scansioni su 5 (logica M su N); una traccia senza misure per troppe scansioni viene eliminata.
Gli stessi strumenti servono ad assemblare gli oggetti dai punti del radar dell’auto, nella lezione dedicata.
In sintesi
- Risoluzione e precisione sono cose diverse: la precisione migliora come la radice del rapporto segnale/rumore e raggiunge il limite di Cramér-Rao.
- In angolo l’errore trasversale cresce con la distanza: l’incertezza di una traccia è un’ellisse allungata.
- Il filtro α-β prevede e corregge con guadagni fissi; il filtro di Kalman calcola i guadagni ottimi, e a regime coincide con un α-β.
- Nessun filtro fisso va bene sia in moto uniforme sia in manovra: l’IMM combina più modelli.
- Con molti bersagli servono finestre di convalida, associazione (GNN, JPDA, MHT) e logiche di conferma delle tracce.
Il codice
import numpy as np

rng = np.random.default_rng(0)
T, passi, sigma = 1.0, 200, 50.0                     # una misura al secondo, errore di misura 50 m
k = np.arange(passi)
vero = 1000 + 100 * k * T + 0.5 * 5.0 * (np.maximum(k - 100, 0) * T) ** 2   # 100 m/s, poi accelera a 5 m/s^2
z = vero + rng.normal(0, sigma, passi)               # misure di distanza

def alfa_beta(alfa):
    beta = alfa ** 2 / (2 - alfa)                    # scelta di Benedict-Bordner
    x, v, stime = z[0], 0.0, []
    for zk in z:
        xp = x + v * T                               # previsione
        r = zk - xp                                  # innovazione: misura meno previsione
        x, v = xp + alfa * r, v + beta / T * r       # correzione
        stime.append(x)
    return np.array(stime), beta

def kalman(q):
    F = np.array([[1, T], [0, 1]]); H = np.array([[1.0, 0.0]])
    Q = q * np.array([[T ** 4 / 4, T ** 3 / 2], [T ** 3 / 2, T ** 2]])   # accelerazione casuale di varianza q
    R = np.array([[sigma ** 2]])
    x, P, stime, guadagni = np.array([z[0], 0.0]), np.diag([sigma ** 2, 1e4]), [], []
    for zk in z:
        x, P = F @ x, F @ P @ F.T + Q                # previsione
        S = H @ P @ H.T + R
        K = P @ H.T / S                              # guadagno di Kalman
        x = x + (K * (zk - H @ x)).ravel()
        P = (np.eye(2) - K @ H) @ P
        stime.append(x[0]); guadagni.append(K.ravel())
    return np.array(stime), guadagni[-1]

def rms(s, a, b):
    return np.sqrt(np.mean((s - vero)[a:b] ** 2))

for alfa in (0.2, 0.5):
    s, beta = alfa_beta(alfa)
    print(f"alfa-beta alfa = {alfa}, beta = {beta:.3f}: errore {rms(s, 20, 100):5.1f} m in moto uniforme, {rms(s, 110, 200):6.1f} m in manovra")
for q in (0.1, 10.0):
    s, K = kalman(q)
    print(f"Kalman q = {q:4}: errore {rms(s, 20, 100):5.1f} m e {rms(s, 110, 200):6.1f} m; guadagni a regime alfa = {K[0]:.3f}, beta = {K[1] * T:.3f}")
print(f"errore delle sole misure: {np.sqrt(np.mean((z - vero) ** 2)):.1f} m")
L’esecuzione del primo programma stampa le righe della tabella sulla precisione e le precisioni d’angolo e di velocità (0,088°, 77 m, 0,234 m/s e 0,0166 m/s). Il secondo stampa le righe della tabella dei filtri: 25,2 e 180,8 m, 33,0 e 36,7 m, 16,3 e 695,6 m con guadagni 0,106 e 0,006, 25,5 e 73,1 m con guadagni 0,299 e 0,053, e 48,1 m per le sole misure.



Benvenuti nella pagina su «Inseguimento radar: precisione delle misure e limite di Cramér-Rao, filtri α-β e di Kalman, IMM e associazione». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Radar tracking: measurement accuracy and the Cramér-Rao bound, α-β and Kalman filters, IMM and association”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.