Prévision de la demande : moyennes mobiles et lissage exponentiel
Moyenne mobile, lissage exponentiel avec poids et âge moyen des données démontrés, un exemple numérique, MAD, MAPE et signal de suivi, méthodes de Holt et de Holt-Winters.
https://www.electronics-engineering.com/fr/prevision-de-la-demande-lissage-exponentiel-erreur/
Toute décision logistique repose sur une prévision de la demande : combien de stock garder, combien de camions réserver, combien produire le mois prochain. Les prévisions sont toujours fausses ; le but est qu’elles le soient seulement un peu, sans erreurs systématiques, et de savoir de combien. Dans cette leçon, nous regardons la moyenne mobile et le lissage exponentiel avec la démonstration de ses poids et de l’âge moyen des données, un exemple numérique, les mesures de l’erreur, et les méthodes pour la tendance et la saisonnalité.
La moyenne mobile
La prévision la plus simple pour la période suivante est la moyenne des  dernières valeurs :
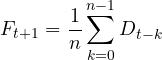
Avec un grand , la prévision est stable mais réagit lentement aux changements ; avec un petit , elle réagit vite mais poursuit aussi le bruit. L’âge moyen des données utilisées est  périodes.
Le lissage exponentiel
Le lissage exponentiel corrige la prévision précédente d’une fraction  de l’erreur :

Il demande de ne mémoriser qu’un seul nombre, et c’est la méthode la plus utilisée dans les systèmes de gestion des stocks. C’est un filtre passe-bas du premier ordre (leçon sur les systèmes à temps discret), comme l’estimation de la durée de rafale dans l’ordonnancement du processeur (leçon de Systèmes d’exploitation sur l’ordonnancement).
Théorème. En développant la récurrence, la prévision est une moyenne pondérée de toutes les données passées, de poids  , dont la somme vaut 1 ; l’âge moyen des données est
 .
Démonstration. En substituant de façon répétée 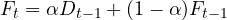 , on obtient
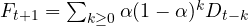 (le reste, multiplié par
 , tend vers zéro). La somme des poids est la série géométrique
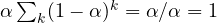 . L’âge moyen est
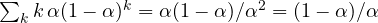 , en utilisant
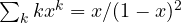 . ∎
Les poids décroissent géométriquement : les données récentes comptent plus, mais aucune n’est tout à fait oubliée. En égalant les âges moyens, le lissage avec équivaut à une moyenne mobile de 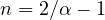 périodes : avec
 , l’âge moyen est de 4 périodes, comme une moyenne mobile sur 9.
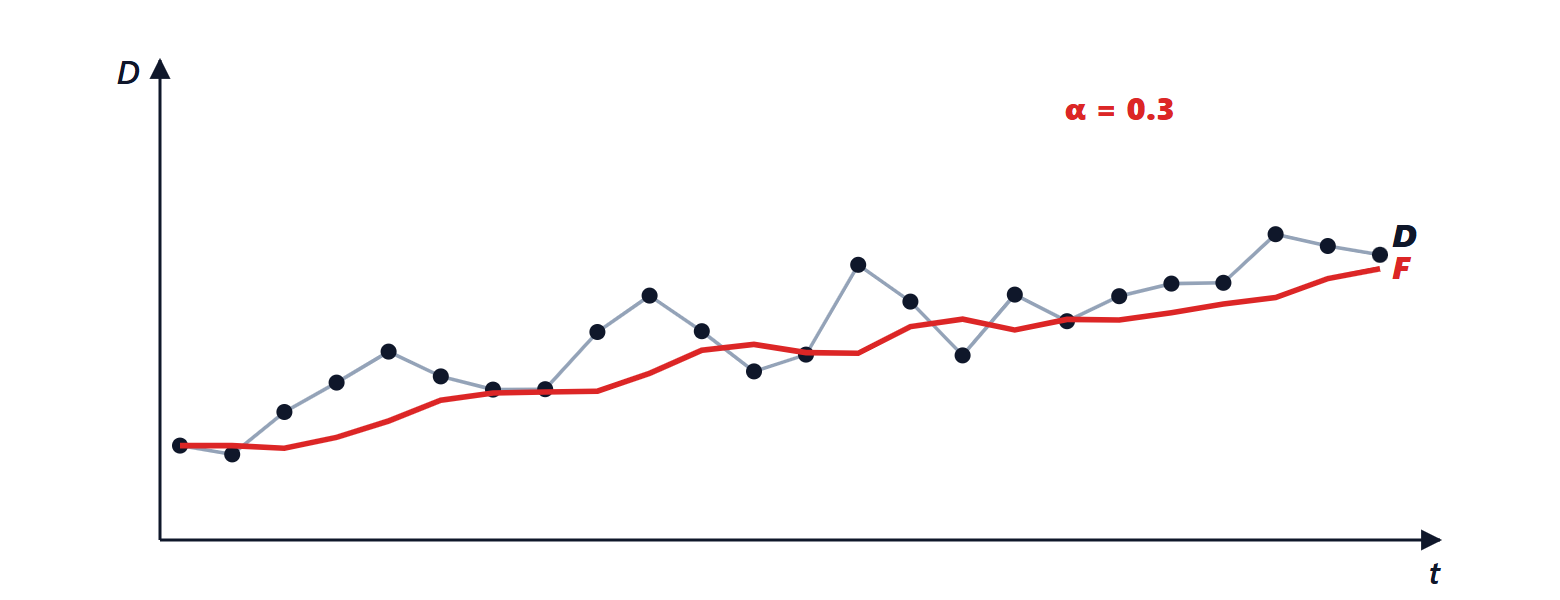
Exemple. Demande 100, 110, 105, 120, 115 pendant les cinq premiers mois,  , prévision initiale 100. Les prévisions des mois 2-6 sont 100, 103, 103,6, 108,5, 110,5. Les erreurs des mois 2-5 sont +10, +2, +16,4, +6,5 : écart absolu moyen (MAD) d’environ 8,7, mais toutes positives.
Mesurer l’erreur
- MAD (mean absolute deviation, écart absolu moyen) ou RMSE (racine de l’erreur quadratique moyenne) : de combien on se trompe en moyenne ; avec des erreurs à peu près normales,
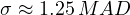 , ce qui intervient dans le calcul du stock de sécurité (leçon sur les stocks).
- MAPE (mean absolute percentage error, erreur absolue moyenne en pourcentage) : comparable entre articles de volumes différents, mais inutilisable avec des demandes proches de zéro.
- Biais : la moyenne des erreurs signées. Il doit être proche de zéro ; le signal de suivi (tracking signal), la somme cumulée des erreurs divisée par le MAD, signale, quand il dépasse environ ±4, que le modèle ne suit plus la demande.
Dans l’exemple, toutes les erreurs sont positives : le lissage simple poursuit une tendance sans la rattraper, parce qu’il suppose un niveau constant.
Tendance et saisonnalité
- La méthode de Holt ajoute une deuxième équation qui estime la pente de la tendance, elle aussi lissée, et la prévision devient le niveau plus la pente multipliée par le nombre de périodes.
- La méthode de Holt-Winters ajoute des coefficients saisonniers (par exemple la demande de climatiseurs en été ou d’électronique à Noël), mis à jour chaque année.
- Les méthodes causales relient la demande à des variables explicatives (prix, promotions, météo) par régression ; les méthodes d’apprentissage automatique combinent de nombreuses variables et de nombreux articles semblables.
Deux règles pratiques valent pour toutes : les prévisions agrégées (par famille de produits, région, mois) sont plus précises que les détaillées, par la même compensation statistique que la loi de la racine carrée (leçon sur la chaîne logistique) ; et plus on regarde loin, plus l’erreur est grande, donc il vaut mieux raccourcir les délais de réponse que prévoir plus loin.





Benvenuti nella pagina su «Previsione della domanda: medie mobili e livellamento esponenziale». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Demand forecasting: moving averages and exponential smoothing”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.