Le Deep Q-Network (DQN) : mémoire de rejeu, réseau cible et double DQN sur CartPole
Le Q-learning avec un réseau de neurones : la triade mortelle, la mémoire de rejeu, le réseau cible, la surestimation du maximum démontrée et le double DQN, vraie fin et limite de temps, code PyTorch qui atteint 500 sur CartPole.
https://www.electronics-engineering.com/fr/deep-q-network-dqn-memoire-de-rejeu-reseau-cible-double-dqn/
Un tableau  fonctionne tant que les états sont peu nombreux. CartPole a quatre variables continues, un jeu vidéo Atari a des images de 210×160 pixels : les états sont infinis ou astronomiquement nombreux. En 2015, DeepMind a montré qu’un réseau de neurones convolutif, entraîné avec le Q-learning et deux astuces, apprend à jouer à 49 jeux Atari en partant seulement des pixels, en dépassant le niveau humain dans beaucoup. C’est le Deep Q-Network (DQN). Cette leçon explique pourquoi le Q-learning avec un réseau de neurones est instable, comment la mémoire de rejeu et le réseau cible le stabilisent, pourquoi le maximum surestime les valeurs (et le remède, le double DQN), et l’applique à CartPole avec un code qui atteint le score maximal.
Du Q-learning tabulaire au réseau
Le tableau est remplacé par une fonction  de paramètres
 (les poids d’un réseau) : l’état en entrée, une valeur par action en sortie. La mise à jour du Q-learning devient un pas de descente de gradient sur la fonction de perte
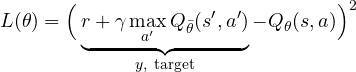
où la cible  est traitée comme une constante (on ne dérive pas par rapport à elle). Cela paraît simple, mais assemblé naïvement, cela diverge souvent.
Pourquoi cela diverge : la triade mortelle
Sutton et Barto appellent triade mortelle la combinaison de trois ingrédients qui, ensemble, peuvent faire diverger l’apprentissage même dans des problèmes simples :
- l’approximation de fonction : changer pour corriger change aussi les valeurs d’états semblables qu’on ne voulait pas toucher ;
- le bootstrap : la cible contient l’estimation elle-même
 , donc une erreur se propage et s’auto-alimente ;
- l’hors-politique : on apprend la politique gloutonne à partir de données recueillies avec une autre politique (celle qui explore).
Le Q-learning profond a les trois. À cela s’ajoute un problème statistique : les pas consécutifs d’un épisode sont fortement corrélés (l’état au pas  est presque égal à celui du pas
 ), alors que la descente de gradient suppose des exemples indépendants.
Les deux astuces du DQN
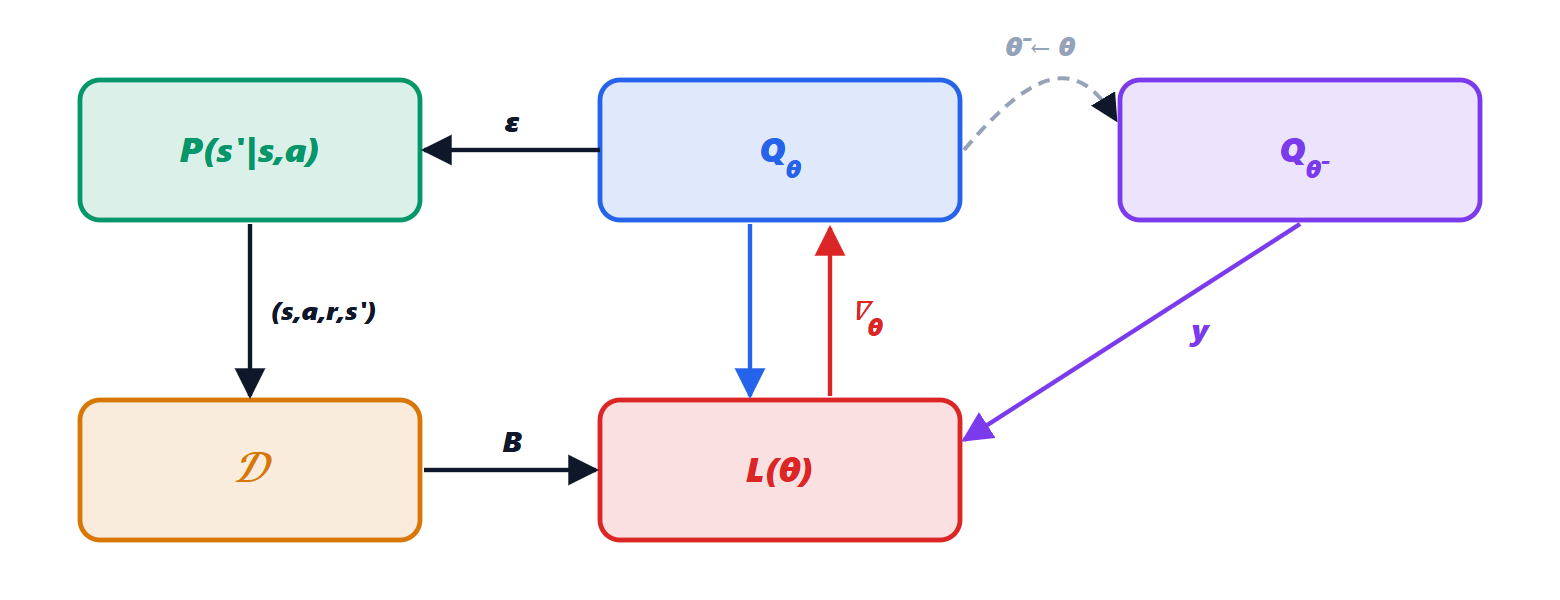
Mémoire de rejeu. Chaque transition 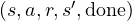 est stockée dans un tampon de quelques dizaines de milliers d’éléments ; à chaque pas d’entraînement, on tire un mini-lot au hasard. Cela brise les corrélations, réutilise chaque expérience de nombreuses fois (ce qui est légitime parce que le Q-learning est hors-politique) et moyenne sur de nombreuses situations différentes.
Réseau cible. La cible est calculée avec une copie des poids,  , mise à jour seulement tous les quelques centaines ou milliers de pas (
 ). Entre deux copies, le problème devient une régression supervisée avec des cibles fixes, et le réseau ne « court pas après sa propre queue ».
Surestimation du maximum et double DQN
Théorème. Si les estimations  sont non biaisées mais bruitées,
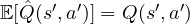 , alors le maximum est surestimé :
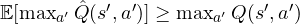 .
Démonstration. Pour tout  ,
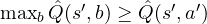 ; en prenant la moyenne,
 , et cela vaut pour tout , donc aussi pour celui qui maximise
 . ∎
Le bruit est « sélectionné » : l’action qui paraît la meilleure est souvent celle qui est estimée trop haut. La surestimation s’accumule par le bootstrap. Le double DQN (van Hasselt, 2016) sépare le choix de l’évaluation : le réseau en ligne choisit l’action, le réseau cible l’évalue,
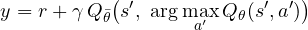
Les erreurs des deux réseaux sont largement indépendantes, et la surestimation est fortement réduite.
Vraie fin et limite de temps. Si l’épisode se termine parce que le bâton est tombé, il n’y a plus de récompense et la cible est juste  . Si en revanche il se termine parce que le temps est écoulé (500 pas dans CartPole), l’état n’est pas terminal : la cible doit encore inclure
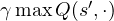 . Confondre les deux cas est l’une des erreurs les plus courantes ; Gymnasium les distingue avec les deux valeurs
terminated et truncated.
Le code sur CartPole
import random, collections
import numpy as np
import torch, torch.nn as nn
import gymnasium

torch.manual_seed(0); random.seed(0); np.random.seed(0)
env = gymnasium.make("CartPole-v1")

def network():
    return nn.Sequential(nn.Linear(4, 128), nn.ReLU(), nn.Linear(128, 128), nn.ReLU(), nn.Linear(128, 2))
q, q_target = network(), network()
q_target.load_state_dict(q.state_dict())
opt = torch.optim.Adam(q.parameters(), lr=2.5e-4)
memory = collections.deque(maxlen=10000)                      # replay memory
STEPS, BATCH, GAMMA, COPY, EVERY, START = 200000, 128, 0.99, 500, 10, 10000

o, _ = env.reset(seed=0)
env.action_space.seed(0)
for t in range(STEPS):
    eps = max(0.05, 1 - 0.95 * t / 100000)                   # decreasing exploration
    if random.random() < eps:
        a = env.action_space.sample()
    else:
        with torch.no_grad():
            a = int(q(torch.tensor(o, dtype=torch.float32)).argmax())
    o2, r, terminated, truncated, _ = env.step(a)
    memory.append((o, a, r, o2, float(terminated)))           # only a true end zeroes the future
    o = o2
    if terminated or truncated:
        o, _ = env.reset()
    if t >= START and t % EVERY == 0:
        b = random.sample(memory, BATCH)
        O, A, R, O2, D = (torch.tensor(np.array(x), dtype=torch.float32) for x in zip(*b))
        with torch.no_grad():                                 # double DQN
            a2 = q(O2).argmax(1, keepdim=True)
            y = R + GAMMA * (1 - D) * q_target(O2).gather(1, a2).squeeze(1)
        estimate = q(O).gather(1, A.long().unsqueeze(1)).squeeze(1)
        loss = nn.functional.mse_loss(estimate, y)
        opt.zero_grad(); loss.backward(); opt.step()
    if t % COPY == 0:
        q_target.load_state_dict(q.state_dict())            # target network update

# greedy evaluation over 20 episodes
scores = []
for e in range(20):
    o, _ = env.reset(seed=1000 + e)
    tot, done = 0.0, False
    while not done:
        with torch.no_grad():
            o, r, te, tr, _ = env.step(int(q(torch.tensor(o, dtype=torch.float32)).argmax()))
        tot += r; done = te or tr
    scores.append(tot)
print("evaluation:", np.mean(scores))
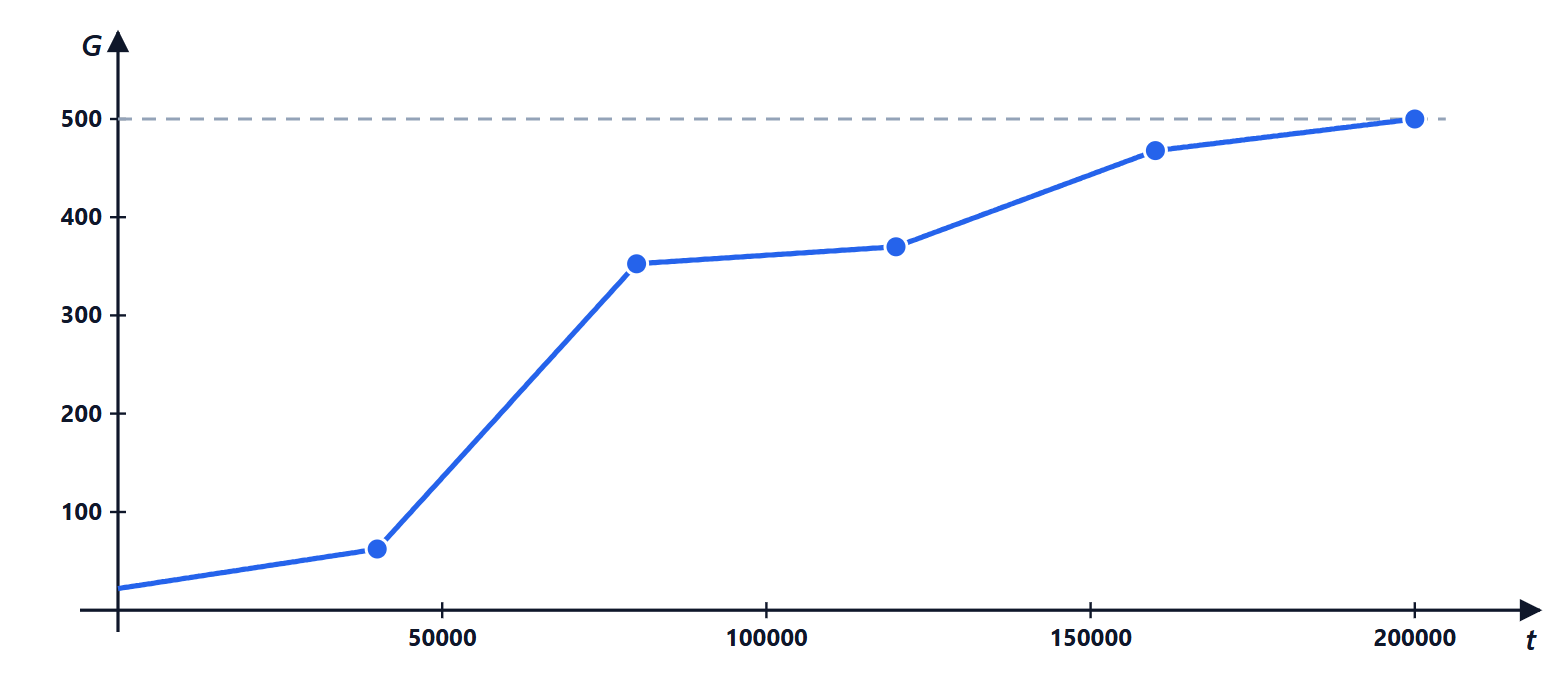
Les hyperparamètres sont ceux de la bibliothèque pédagogique CleanRL. Pendant l’entraînement, le retour moyen passe de 62 (après 40 000 pas) à 353, 370, 468 et 500 ; l’évaluation gloutonne finale est de 500 sur 20 épisodes, le maximum possible. Sur un processeur ordinaire, cela prend moins d’une minute.
Au-delà du DQN
Le DQN fonctionne avec peu d’actions discrètes (il doit calculer le maximum sur toutes). Pour des actions continues, comme les couples d’un robot ou le braquage d’une voiture, on utilise des méthodes acteur-critique (DDPG, TD3, SAC), qui apprennent aussi une politique, ainsi que les méthodes de gradient de politique de la leçon suivante. Les variantes du DQN pour les jeux (Rainbow) ajoutent le rejeu prioritaire, les réseaux « dueling », les retours à plusieurs pas et les distributions de retour ; le principe reste celui décrit ici.


Sono l'autore di questa pagina su «Il Deep Q-Network (DQN): memoria di replay, rete bersaglio e double DQN su CartPole». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “The Deep Q-Network (DQN): replay memory, target network and double DQN on CartPole”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.