Monte Carlo et différences temporelles : SARSA et Q-learning sur l'exemple de la falaise
Apprendre des valeurs à partir de l'expérience : Monte Carlo, TD(0), conditions de convergence, SARSA sur la politique et Q-learning hors politique, l'exemple de la falaise avec chemin sûr et optimal, code vérifié.
https://www.electronics-engineering.com/fr/differences-temporelles-sarsa-q-learning-falaise/
Les équations de Bellman exigent de connaître les probabilités de transition  et les récompenses
 . On ne les connaît presque jamais : un robot n’a pas de formule pour savoir comment il glissera sur le sol, un jeu ne dit pas à l’avance les coups de l’adversaire. On peut cependant essayer et observer ce qui se passe. Cette leçon présente les méthodes qui apprennent des valeurs à partir de l’expérience : Monte Carlo, qui attend la fin de l’épisode, et les différences temporelles (TD), qui mettent à jour à chaque pas. On en tire SARSA et le Q-learning, que nous comparons sur l’exemple classique de la falaise, avec du code et des résultats.
Monte Carlo : la moyenne des retours
La valeur est une moyenne : 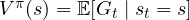 . La façon la plus directe de l’estimer est de jouer de nombreux épisodes en suivant
 , de calculer le retour
 chaque fois que
 est visité et de faire la moyenne. Sous forme incrémentale, après chaque retour observé :
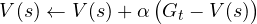
avec  le taux d’apprentissage. Avec
 (n nombre de visites), c’est exactement la moyenne arithmétique. Monte Carlo ne fait aucune hypothèse sur l’environnement, mais il doit attendre la fin de l’épisode et ses estimations ont une forte variance : additionne de nombreuses récompenses aléatoires.
Les différences temporelles
L’idée de Sutton (1988) est de remplacer le vrai retour, connu seulement à la fin, par une estimation construite avec l’équation de Bellman : 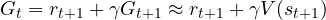 . La mise à jour TD(0) est
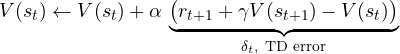
L’apprentissage se fait à chaque pas, même dans des tâches sans fin. L’estimation utilise une autre estimation (on dit qu’elle fait du bootstrap) : elle a moins de variance que Monte Carlo, parce qu’elle dépend d’une seule récompense aléatoire, mais elle est biaisée tant que  est fausse. Le compromis biais-variance entre Monte Carlo et TD se règle avec les retours à
 pas et le paramètre
 (TD(), et dans sa version moderne le GAE utilisé par PPO).
Convergence. Avec un tableau, si chaque état est visité infiniment souvent et que les pas vérifient les conditions de Robbins-Monro,  et
 (par exemple
 ), TD(0) converge vers
 avec une probabilité 1. L’idée de la démonstration : en moyenne, la mise à jour applique l’opérateur de Bellman, qui est une contraction ; la première condition permet d’arriver n’importe où, la seconde éteint le bruit.
De la valeur à l’action : SARSA et Q-learning
Pour choisir des actions sans modèle, il faut  , non
 : avec , il faudrait savoir où mène chaque action. En explorant avec une politique ε-gloutonne (meilleure action selon
 avec une probabilité
 , aléatoire avec une probabilité
 ), on met à jour après chaque transition
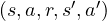 :
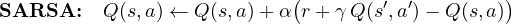
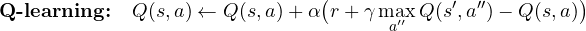
La seule différence est la cible. SARSA utilise l’action  que l’agent va réellement prendre (exploration comprise) : il apprend la valeur de la politique qu’il suit, et s’appelle sur la politique (on-policy). Le Q-learning utilise le maximum, c’est-à-dire l’action que prendrait la politique optimale : il apprend
 quelle que soit la façon dont il explore, et s’appelle hors politique (off-policy, Watkins, 1989). Être hors politique est justement ce qui permet de réutiliser une vieille expérience ou une expérience recueillie par d’autres, et c’est la base du DQN.
L’exemple de la falaise
Une grille 4×12 : le départ est en bas à gauche, la sortie en bas à droite, et les cases du bas entre les deux sont une falaise : tomber donne  et renvoie au départ. Chaque pas coûte
 . Le plus court chemin longe le bord de la falaise (13 pas) ; un chemin plus sûr passe plus haut.
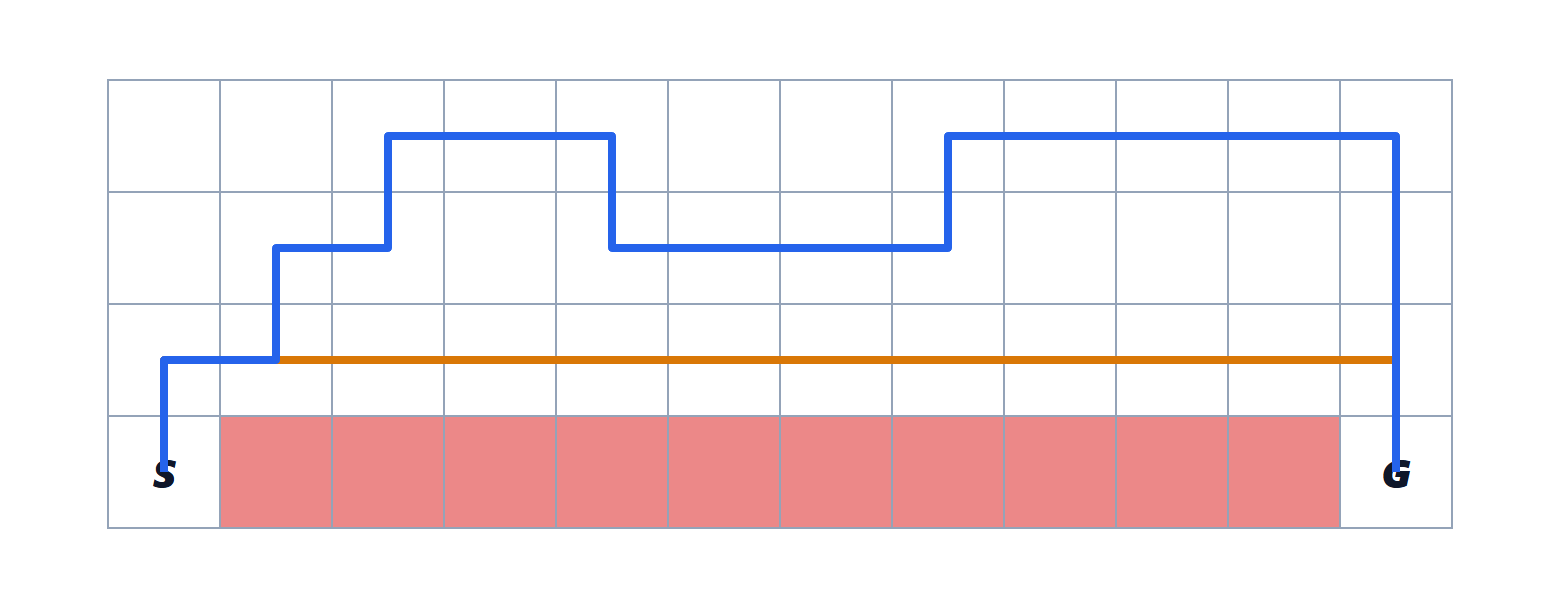
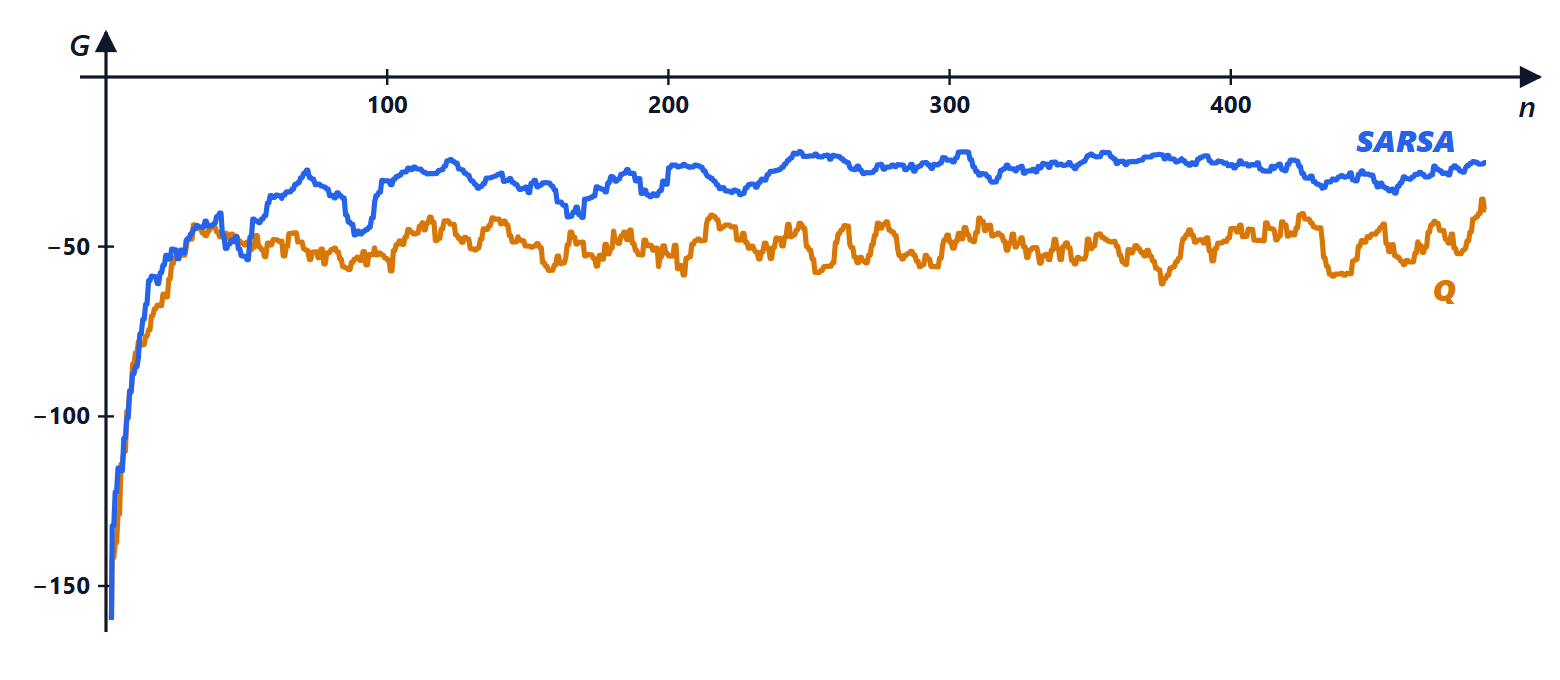
Avec  ,
 et 500 épisodes (moyenne sur 20 graines aléatoires) :
| chemin appris | retour moyen sur les 100 derniers épisodes | |
|---|---|---|
| SARSA | sûr, 19 pas | −28,1 |
| Q-learning | optimal, 13 pas | −48,0 |
Le Q-learning trouve le meilleur chemin, mais gagne moins pendant qu’il apprend : en marchant sur le bord, le mouvement aléatoire de 10 % le fait tomber souvent. SARSA sait qu’il va explorer et préfère rester loin du bord. C’est une leçon qui s’applique aux systèmes réels : un robot qui apprend sur une installation réelle doit tenir compte de sa propre exploration, et les algorithmes sur la politique ou « prudents » sont souvent préférables ; en simulation, où tomber ne coûte rien, on peut utiliser le Q-learning puis éteindre l’exploration.
Le code
import numpy as np

ROWS, COLS = 4, 12
START, EXIT = (3, 0), (3, 11)
MOVES = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(pos, a):
    r = min(max(pos[0] + MOVES[a][0], 0), ROWS - 1)
    c = min(max(pos[1] + MOVES[a][1], 0), COLS - 1)
    if r == 3 and 1 <= c <= 10:            # cliff: -100 and back to the start
        return START, -100.0, False
    return (r, c), -1.0, (r, c) == EXIT

def learn(method, episodes=500, alpha=0.5, eps=0.1, seed=0):
    rng = np.random.default_rng(seed)
    Q = np.zeros((ROWS, COLS, 4))
    def choose(p):                          # epsilon-greedy (tiny noise to break ties)
        return rng.integers(4) if rng.random() < eps else int(np.argmax(Q[p] + 1e-9 * rng.random(4)))
    returns = []
    for _ in range(episodes):
        p, tot = START, 0.0
        a = choose(p)
        for _ in range(1000):
            p2, r, done = step(p, a)
            tot += r
            a2 = choose(p2)
            if method == "sarsa":
                target = r if done else r + Q[p2][a2]               # action actually chosen
            else:
                target = r if done else r + np.max(Q[p2])           # best action
            Q[p][a] += alpha * (target - Q[p][a])
            p, a = p2, a2
            if done:
                break
        returns.append(tot)
    return np.array(returns), Q

for method in ("sarsa", "qlearning"):
    curves = np.array([learn(method, seed=s)[0] for s in range(20)])
    _, Q = learn(method, seed=0)
    p, length, done = START, 0, False
    while not done and length < 50:         # final greedy path
        p, _, done = step(p, int(np.argmax(Q[p])))
        length += 1
    print(f"{method:9s}: last 100 episodes {curves[:, -100:].mean():6.1f}, path of {length} steps")
L’exécution affiche  et 19 pas pour SARSA,
 et 13 pas pour le Q-learning. Un tableau avec une case par couple état-action fonctionne tant que les états se comptent en milliers ; pour CartPole (états continus) ou un jeu vidéo (états faits de pixels), il faut une approximation : le tableau devient un réseau de neurones, le DQN de la leçon suivante.


Sono l'autore di questa pagina su «Monte Carlo e differenze temporali: SARSA e Q-learning sull’esempio della scogliera». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Monte Carlo and temporal differences: SARSA and Q-learning on the cliff example”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.