Gradient de politique et PPO : REINFORCE, ligne de base, acteur-critique, GAE et objectif écrêté
Le théorème du gradient de politique démontré, REINFORCE, la ligne de base qui n'introduit pas de biais, acteur-critique, l'avantage généralisé GAE, l'objectif PPO écrêté, code sur CartPole avec des environnements vectorisés.
https://www.electronics-engineering.com/fr/gradient-de-politique-reinforce-acteur-critique-gae-ppo/
Le DQN apprend des valeurs et en tire la politique. On peut aussi faire l’inverse : paramétrer directement la politique  avec un réseau de neurones et déplacer ses poids dans la direction qui augmente le retour moyen. Ce sont les méthodes de gradient de politique. Elles fonctionnent avec des actions continues (couples, braquage, accélération), apprennent des politiques stochastiques et sont la base du PPO (Proximal Policy Optimization, Schulman et al., 2017), l’algorithme le plus utilisé aujourd’hui : des robots qui marchent aux modèles de langage entraînés avec retour humain. Cette leçon démontre le théorème du gradient de politique, établit REINFORCE, la ligne de base et l’acteur-critique, explique l’avantage généralisé (GAE) et l’objectif « écrêté » du PPO, et l’applique à CartPole.
Le théorème du gradient de politique
L’objectif est le retour moyen 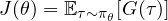 , où
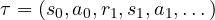 est une trajectoire et
 son retour.
Théorème. 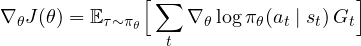 , avec
 le retour à partir de
 .
Démonstration. La probabilité d’une trajectoire est 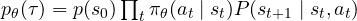 . On utilise l’astuce de la dérivée logarithmique,
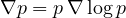 :
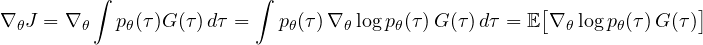
Dans le logarithme, le produit devient une somme, et les termes  et
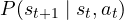 ne dépendent pas de
 : ils disparaissent en dérivant. Il reste
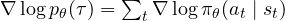 . Enfin, les récompenses reçues avant ne dépendent pas de
 , et leur contribution a une moyenne nulle (par le même argument que pour la ligne de base ci-dessous) : on peut remplacer par . ∎
Le résultat est remarquable : pour améliorer la politique, le modèle de l’environnement n’est pas nécessaire, il suffit de savoir dériver sa propre politique. L’interprétation est intuitive : augmenter la probabilité des actions suivies d’un retour élevé, diminuer celle des actions suivies d’un retour faible. Estimer la moyenne avec les trajectoires jouées donne l’algorithme REINFORCE (Williams, 1992).
La ligne de base et l’acteur-critique
REINFORCE est correct mais très lent : a une variance énorme. On peut soustraire une ligne de base  sans changer la moyenne.
Lemme.  .
Démonstration. 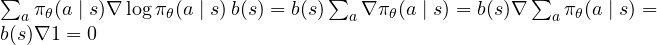 . ∎
Le choix naturel est  : au lieu de , on utilise l’avantage
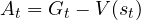 , qui dit de combien mieux que prévu l’action s’est passée.
 est appris avec un second réseau, le critique, tandis que la politique est l’acteur : c’est le schéma acteur-critique, la version « évaluer et améliorer » de l’itération de politique.
Avantage généralisé (GAE). Comme entre Monte Carlo et TD, l’avantage peut s’estimer avec l’erreur TD 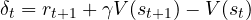 (faible variance, biaisée) ou avec tout le retour (non biaisé, forte variance). Le GAE (Schulman, 2016) prend une moyenne exponentielle :
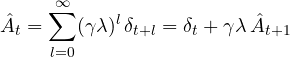
avec  , on obtient l’erreur TD, avec
 le retour de Monte Carlo moins ; d’ordinaire
 . La forme récursive se calcule à rebours en une ligne de code.
PPO : de grands pas, mais pas trop grands
Un pas de gradient trop long peut changer la politique au point de la ruiner, et les données recueillies avec l’ancienne politique ne sont plus valables. Le PPO utilise le rapport de probabilités 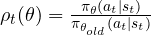 entre la nouvelle politique et celle qui a recueilli les données, et maximise l’objectif écrêté :
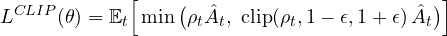
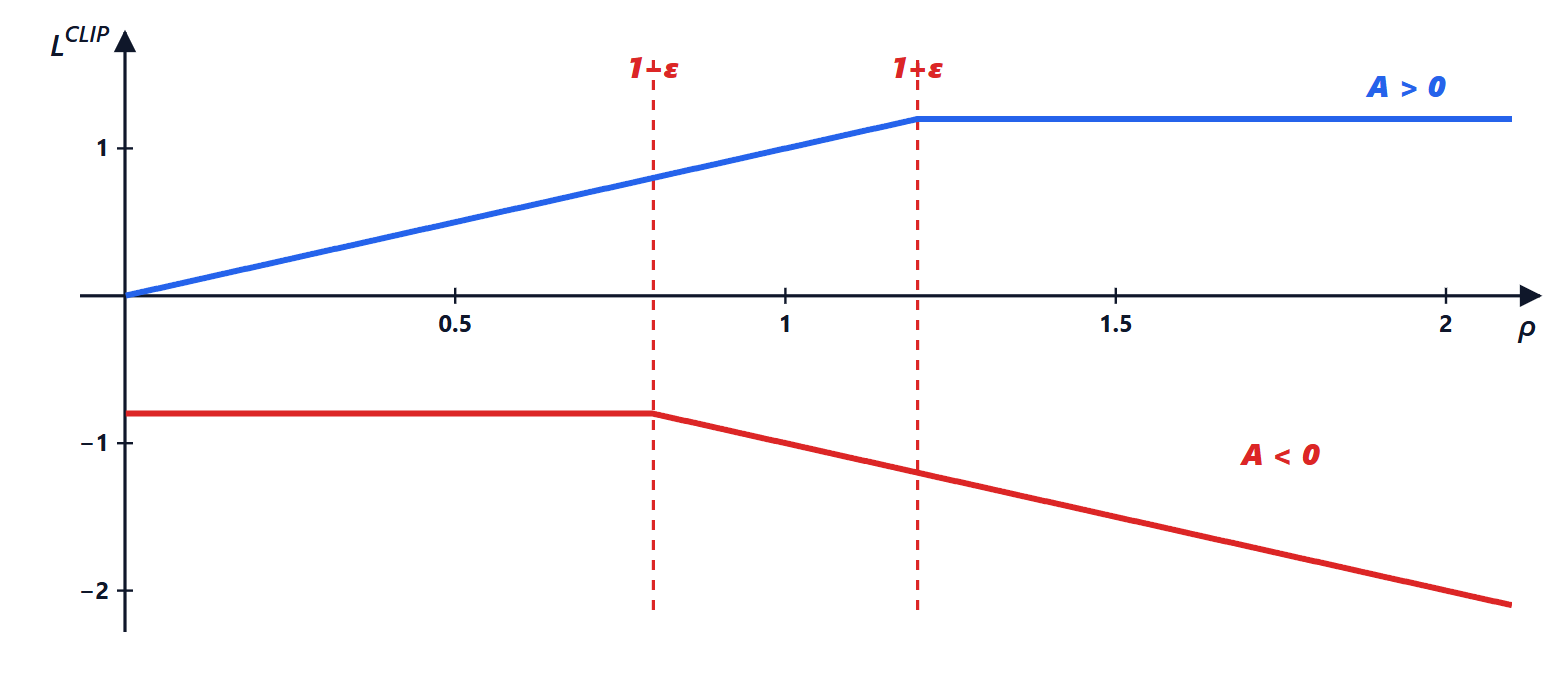
avec  . Si une action était bonne (
 ), sa probabilité est augmentée, mais au-delà de 20 % de plus l’objectif devient plat et le gradient s’annule ; si elle était mauvaise (
 ), sa probabilité est réduite, mais pas en dessous de 20 % de moins. Le minimum garantit que l’écrêtage n’agit que lorsqu’il améliorerait l’objectif, jamais quand il le dégrade : c’est une borne pessimiste du gain. Ainsi, plusieurs pas (époques) peuvent être faits en sécurité sur les mêmes données. L’erreur du critique et un petit bonus d’entropie, qui garde l’exploration vivante, sont ajoutés à l’objectif.
PPO sur CartPole
Le code recueille 128 pas de 8 environnements en parallèle (1024 transitions), calcule le GAE, effectue 4 époques de mise à jour avec l’objectif écrêté et répète 100 fois. Les environnements sont vectorisés avec PufferLib, présentée dans la leçon sur les bibliothèques ; avec Gymnasium (gymnasium.vector.SyncVectorEnv), le code serait presque identique.
import numpy as np
import torch, torch.nn as nn
import gymnasium
import pufferlib.emulation, pufferlib.vector

N_ENV, T, UPDATES = 8, 128, 100                  # 8 environments, 128 steps each per update
GAMMA, LAM, CLIP, LR, EPOCHS = 0.99, 0.95, 0.2, 1e-3, 4
torch.manual_seed(0)

def make(buf=None, seed=0):
    return pufferlib.emulation.GymnasiumPufferEnv(env=gymnasium.make("CartPole-v1"), buf=buf, seed=seed)
envs = pufferlib.vector.make(make, num_envs=N_ENV, backend=pufferlib.vector.Serial)
obs, _ = envs.reset(seed=0)

actor = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 64), nn.Tanh(), nn.Linear(64, 2))
critic = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 1))
params = list(actor.parameters()) + list(critic.parameters())
opt = torch.optim.Adam(params, lr=LR)

for k in range(UPDATES):
    for g in opt.param_groups:
        g["lr"] = LR * (1 - k / UPDATES)                # learning rate decreasing linearly to zero
    O, A, LP, R, D, V = [], [], [], [], [], []
    for t in range(T):                                  # data collection with the current policy
        o = torch.tensor(obs, dtype=torch.float32)      # copy: PufferLib reuses the same buffer
        with torch.no_grad():
            dist = torch.distributions.Categorical(logits=actor(o))
            a = dist.sample()
            O.append(o); A.append(a); LP.append(dist.log_prob(a)); V.append(critic(o).squeeze(-1))
        obs, r, term, trunc, _ = envs.step(a.numpy())
        R.append(torch.tensor(r, dtype=torch.float32))
        D.append(torch.tensor(np.logical_or(term, trunc), dtype=torch.float32))
    with torch.no_grad():
        v_end = critic(torch.tensor(obs, dtype=torch.float32)).squeeze(-1)
    adv, last = torch.zeros(T, N_ENV), torch.zeros(N_ENV)
    for t in reversed(range(T)):                        # GAE, computed backwards
        v_next = v_end if t == T - 1 else V[t + 1]
        delta = R[t] + GAMMA * v_next * (1 - D[t]) - V[t]
        last = delta + GAMMA * LAM * (1 - D[t]) * last
        adv[t] = last
    returns = (adv + torch.stack(V)).reshape(-1)
    O, A, LP = torch.stack(O).reshape(-1, 4), torch.stack(A).reshape(-1), torch.stack(LP).reshape(-1)
    adv = adv.reshape(-1)
    adv = (adv - adv.mean()) / (adv.std() + 1e-8)
    for _ in range(EPOCHS):                             # clipped PPO objective
        dist = torch.distributions.Categorical(logits=actor(O))
        ratio = torch.exp(dist.log_prob(A) - LP)
        loss_pi = -torch.min(ratio * adv, torch.clamp(ratio, 1 - CLIP, 1 + CLIP) * adv).mean()
        loss_v = ((critic(O).squeeze(-1) - returns) ** 2).mean()
        loss = loss_pi + 0.5 * loss_v - 0.01 * dist.entropy().mean()
        opt.zero_grad(); loss.backward()
        nn.utils.clip_grad_norm_(params, 0.5)
        opt.step()
envs.close()

env, scores = gymnasium.make("CartPole-v1"), []
for e in range(10):                                     # evaluation with the most likely action
    o, _ = env.reset(seed=100 + e)
    tot, done = 0.0, False
    while not done:
        with torch.no_grad():
            o, r, te, tr, _ = env.step(int(actor(torch.tensor(o, dtype=torch.float32)).argmax()))
        tot += r; done = te or tr
    scores.append(tot)
print("evaluation over 10 episodes:", np.mean(scores))
torch.save(actor.state_dict(), "expert.pt")             # will serve as the expert to imitate
En moins de 10 secondes sur un processeur (environ 100 000 pas), le retour moyen des 20 derniers épisodes pendant l’entraînement passe de 162 après 20 mises à jour à 245, 201, 401 et 407 (pendant l’entraînement, les actions sont encore aléatoires), et l’évaluation avec l’action la plus probable donne 500 sur les 10 épisodes. Deux astuces ont été décisives dans les essais : le taux d’apprentissage qui décroît jusqu’à zéro et la limite de la norme du gradient (0,5) ; sans elles, la politique atteignait 400 puis se dégradait. C’est typique de l’AR : les résultats changent beaucoup avec les hyperparamètres et avec la graine aléatoire, et l’on utilise toujours plusieurs graines pour comparer deux méthodes. Une simplification : le code traite aussi la limite de temps (500 pas) comme terminale, ce qui, strictement, demanderait de continuer le bootstrap ; pour CartPole, l’effet est petit.
Pourquoi le PPO est partout
Il est simple (quelques lignes en plus de l’acteur-critique), plus robuste aux hyperparamètres que beaucoup de concurrents, fonctionne avec des actions discrètes et continues et se parallélise bien sur des milliers d’environnements simulés. C’est l’algorithme avec lequel OpenAI a entraîné la main robotique qui a résolu le Rubik’s cube et les bots de Dota 2, et celui utilisé en 2022 pour InstructGPT, le modèle de langage qui a rendu célèbre l’entraînement avec retour humain (RLHF), comme le montre la leçon sur les applications.


Ciao, sono l'autore di «Gradiente della policy e PPO: REINFORCE, baseline, actor-critic, GAE e obiettivo ritagliato». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Policy gradient and PPO: REINFORCE, baseline, actor-critic, GAE and clipped objective”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.