Apprentissage par imitation : clonage de comportement, accumulation d'erreurs, DAgger et AR inverse
Apprendre à partir de démonstrations : clonage de comportement, le théorème d'accumulation des erreurs, DAgger, expériences sur CartPole avec 10 graines, AR inverse, GAIL, imitation et renforcement dans AlphaGo, les modèles de langage et la robotique.
https://www.electronics-engineering.com/fr/apprentissage-par-imitation-clonage-de-comportement-dagger-ar-inverse/
Définir une récompense qui décrit bien une tâche est souvent plus difficile que la tâche elle-même : comment écrire sous forme de nombre « conduis comme un expert », ou « plie la chemise proprement » ? Il est bien plus facile de montrer comment on fait. L’apprentissage par imitation apprend une politique à partir de démonstrations d’un expert : un conducteur, un opérateur qui guide un robot à distance, un programme déjà bon. C’est la base des premiers systèmes de conduite autonome, de nombreux robots manipulateurs et aussi de la première étape d’entraînement des modèles de langage. Cette leçon présente le clonage de comportement, démontre pourquoi ses erreurs s’accumulent, présente DAgger, qui résout le problème, et esquisse l’apprentissage inverse de la récompense. Des expériences sur CartPole montrent tout en chiffres.
Le clonage de comportement
L’idée la plus simple : recueillir des couples (état, action de l’expert) et entraîner un réseau à prédire l’action à partir de l’état, comme dans un problème de classification (actions discrètes) ou de régression (actions continues). Pas de récompense, pas d’exploration : c’est de l’apprentissage supervisé. En 1989, ALVINN conduisait une camionnette en apprenant l’angle de braquage à partir d’images de caméra et des manœuvres d’un conducteur ; en 2016, NVIDIA a fait de même avec un réseau convolutif (PilotNet).
Pourquoi les erreurs s’accumulent
Le clonage de comportement a un défaut profond : le réseau est entraîné sur les états visités par l’expert, mais est utilisé sur les états visités par lui-même. Une petite erreur suffit à conduire l’agent dans un état un peu différent de ceux qu’il a vus ; là, le réseau fait de plus grandes erreurs, et l’état dérive davantage. Les erreurs se composent.
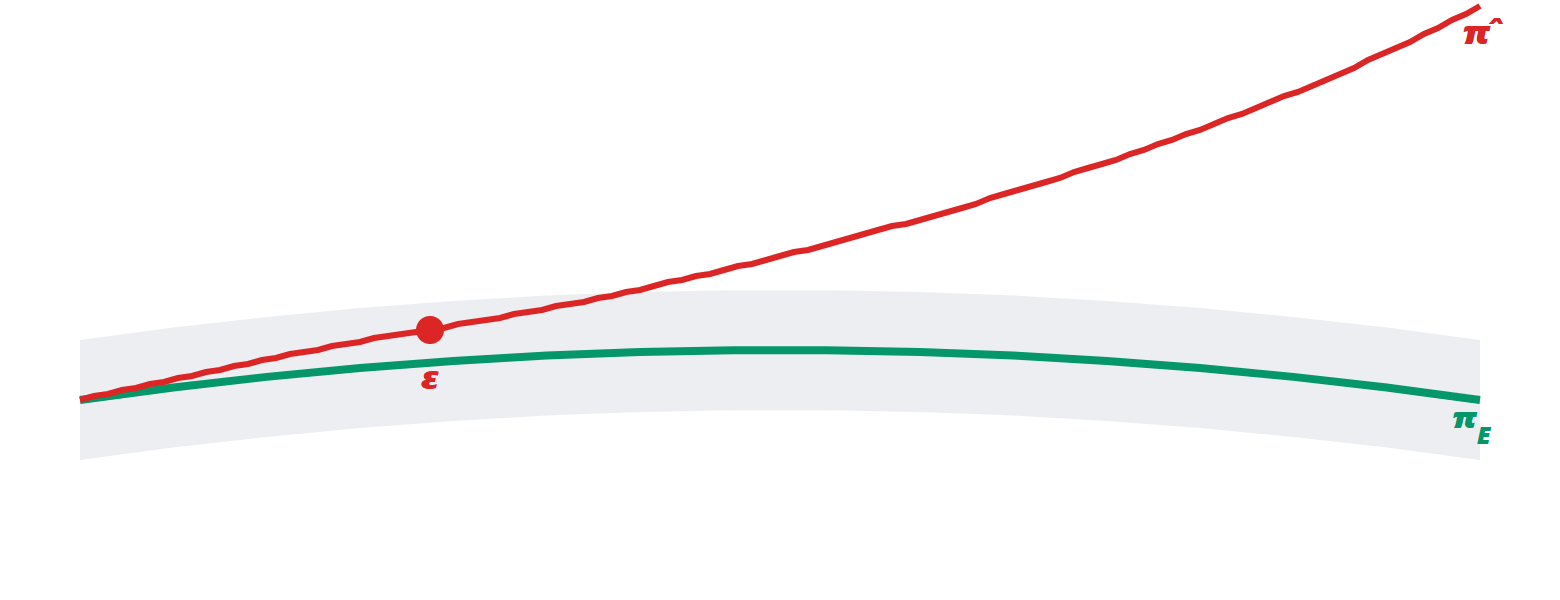
Théorème (Ross et Bagnell, 2010). Si la politique clonée choisit la mauvaise action avec une probabilité au plus  sur les états de l’expert, et qu’une erreur peut la faire sortir de la distribution de l’expert pour le reste de l’épisode, le coût attendu sur un horizon de
 pas peut croître comme
 , au lieu de
 .
Idée de la démonstration. Tant que l’agent n’a pas encore fait d’erreur, il est dans les états de l’expert et se trompe avec une probabilité par pas. La probabilité d’avoir déjà fait une erreur au pas  est d’environ
 (pour petit), et après la première erreur, dans le pire des cas, on paie un coût à chaque pas suivant. Le coût attendu est donc
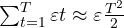 . Si au contraire la politique était entraînée sur les états que elle-même visite, l’erreur par pas resterait et le coût . ∎
DAgger : demander à l’expert où cela a mal tourné
DAgger (Dataset Aggregation, Ross, Gordon et Bagnell, 2011) guérit le problème à la racine : on laisse la politique apprise conduire, on enregistre les états qu’elle visite, on demande à l’expert quelle action il aurait choisie dans ces états, on ajoute les nouveaux couples aux données et l’on réentraîne. En répétant, les données couvrent exactement les états où l’agent finit, y compris ceux où il doit « se rattraper ». Le théorème de DAgger garantit un coût qui croît comme . Le prix : l’expert doit être disponible pendant l’entraînement (un programme, un simulateur avec un contrôleur optimal, ou une personne qui corrige après coup).
Les expériences sur CartPole
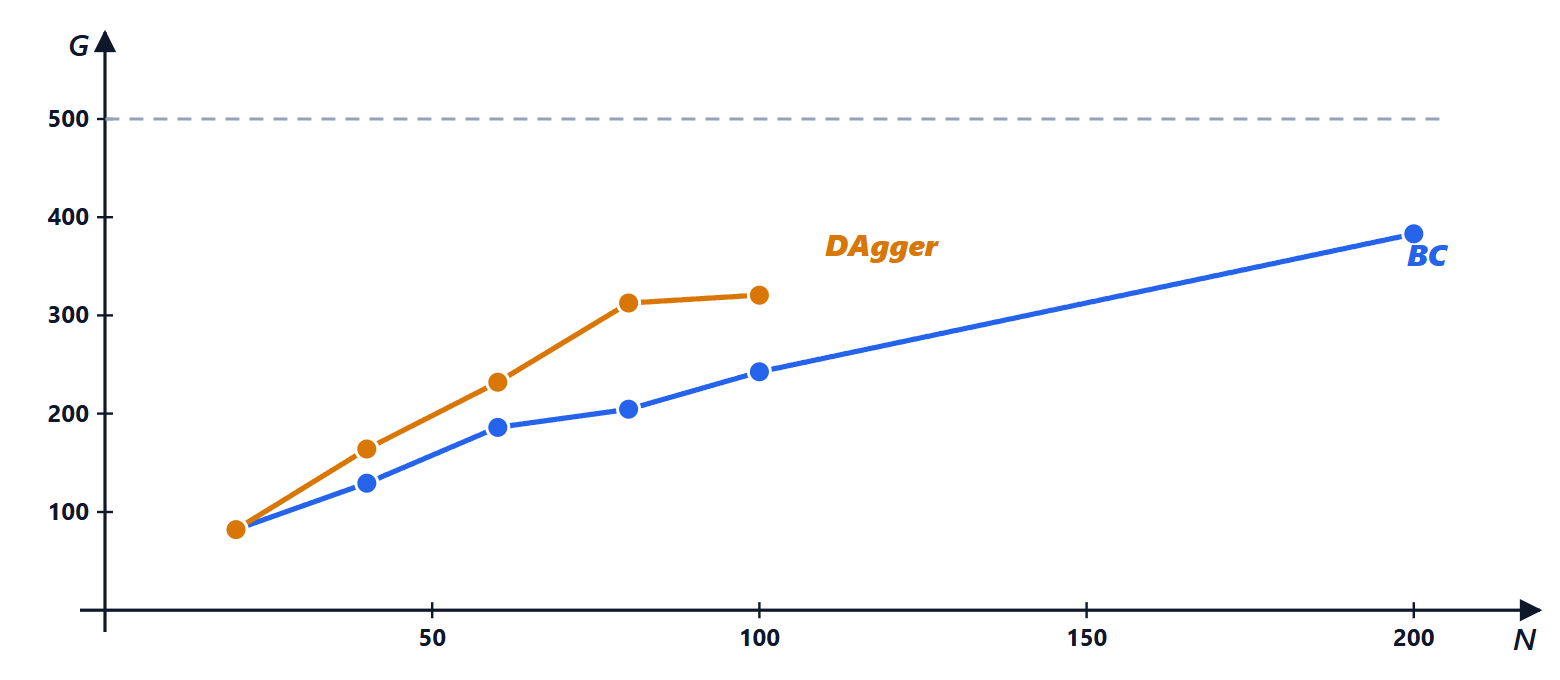
L’expert est le PPO de la leçon précédente, qui garde le bâton debout pendant les 500 pas. La politique qui imite est un petit réseau (une couche cachée de 32 neurones), entraîné à classer l’action et évalué sur 20 épisodes. Avec si peu de données, le résultat dépend beaucoup du hasard (quels états apparaissent dans les démonstrations, comment le réseau démarre), donc chaque configuration est répétée avec 10 graines aléatoires et l’on donne la moyenne et l’écart type.
| pas de données | clonage de comportement | DAgger |
|---|---|---|
| 20 | 82 ± 23 | 82 ± 23 (point de départ) |
| 40 | 129 ± 103 | 164 ± 127 |
| 60 | 186 ± 140 | 232 ± 103 |
| 80 | 205 ± 121 | 313 ± 105 |
| 100 | 243 ± 146 | 321 ± 110 |
| 200 | 383 ± 130 |
À quantité de données égale, DAgger est toujours meilleur, et avec 80-100 pas il obtient ce que le clonage de comportement atteint avec environ deux fois plus. La raison est celle du théorème : les démonstrations de l’expert ne montrent presque que le bâton proche de la verticale, tandis que DAgger ajoute justement les « mauvais » états où l’agent finit, avec la bonne action pour se rattraper. Les écarts types sont grands : avec une graine chanceuse, même le clonage de comportement peut atteindre 500, avec une malchanceuse rester sous 100. C’est un avertissement général : en AR et en imitation, une seule expérience ne prouve rien.
import numpy as np
import torch, torch.nn as nn
import gymnasium

expert = nn.Sequential(nn.Linear(4, 64), nn.Tanh(), nn.Linear(64, 64), nn.Tanh(), nn.Linear(64, 2))
expert.load_state_dict(torch.load("expert.pt"))               # saved by the code of the PPO lesson
expert_action = lambda s: int(expert(torch.tensor(s, dtype=torch.float32)).argmax())

def evaluate(policy, episodes=20):
    env, scores = gymnasium.make("CartPole-v1"), []
    for e in range(episodes):
        o, _ = env.reset(seed=1000 + e)
        tot, done = 0.0, False
        while not done:
            o, r, te, tr, _ = env.step(policy(o))
            tot += r; done = te or tr
        scores.append(tot)
    return float(np.mean(scores))

def collect(policy, steps, seed):
    """States visited following policy, labelled with the expert's action."""
    env, S, Y = gymnasium.make("CartPole-v1"), [], []
    o, _ = env.reset(seed=seed)
    for _ in range(steps):
        S.append(o); Y.append(expert_action(o))
        o, _, te, tr, _ = env.step(policy(o))
        if te or tr:
            o, _ = env.reset()
    return S, Y

def train(S, Y, seed):
    torch.manual_seed(seed)
    net = nn.Sequential(nn.Linear(4, 32), nn.Tanh(), nn.Linear(32, 2))
    opt = torch.optim.Adam(net.parameters(), lr=1e-2)
    X, T = torch.tensor(np.array(S), dtype=torch.float32), torch.tensor(Y)
    for _ in range(300):                                       # classification of the action
        loss = nn.functional.cross_entropy(net(X), T)
        opt.zero_grad(); loss.backward(); opt.step()
    return lambda s: int(net(torch.tensor(s, dtype=torch.float32)).argmax())

print("expert:", evaluate(expert_action))
bc = {n: [] for n in (20, 40, 60, 80, 100, 200)}
dag = {n: [] for n in (20, 40, 60, 80, 100)}
for seed in range(10):
    for n in bc:                                               # behaviour cloning with n steps
        bc[n].append(evaluate(train(*collect(expert_action, n, 100 * seed), seed)))
    S, Y = collect(expert_action, 20, 100 * seed)              # DAgger: start from 20 steps
    policy = train(S, Y, seed)
    dag[20].append(evaluate(policy))
    for it in range(1, 5):
        S2, Y2 = collect(policy, 20, 100 * seed + it)          # states visited by the learned policy
        S += S2; Y += Y2
        policy = train(S, Y, seed)
        dag[20 * (it + 1)].append(evaluate(policy))
for n in bc:
    row = f"{n:4d} steps: behaviour cloning {np.mean(bc[n]):6.1f} ± {np.std(bc[n]):5.1f}"
    if n in dag:
        row += f", DAgger {np.mean(dag[n]):6.1f} ± {np.std(dag[n]):5.1f}"
    print(row)
Au-delà de l’imitation directe
- L’apprentissage par renforcement inverse (AR inverse) : au lieu de copier les actions, on cherche la récompense que l’expert semble maximiser, puis on l’optimise avec l’AR. C’est plus robuste hors des démonstrations, parce que la récompense est valable aussi dans des états jamais vus.
- Le GAIL (generative adversarial imitation learning, 2016) : un discriminateur apprend à distinguer les trajectoires de l’expert de celles de l’agent, et l’agent est entraîné par AR à le « tromper », comme dans les réseaux antagonistes génératifs.
- Imitation, puis renforcement : en pratique, on commence souvent par le clonage de comportement (rapide, stable) et l’on améliore avec l’AR. C’est le schéma d’AlphaGo (d’abord les parties des maîtres, puis l’auto-jeu) et des modèles de langage (d’abord un entraînement supervisé sur des réponses écrites par des personnes, puis l’AR avec retour humain).
- La robotique moderne : les politiques de diffusion et les modèles vision-langage-action apprennent à partir de milliers de démonstrations téléopérées ; l’accumulation d’erreurs est atténuée en prédisant des blocs d’actions futures au lieu d’une seule.





Ciao, sono l'autore di «Apprendimento per imitazione: behaviour cloning, accumulo degli errori, DAgger e inverse RL». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Imitation learning: behaviour cloning, error accumulation, DAgger and inverse RL”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.