Applications de l'AR : jeux, robotique, conduite autonome, RLHF et DPO pour les modèles de langage
AlphaGo et AlphaZero, locomotion, drones et plasma, l'AR dans les voitures, le RLHF avec le modèle de Bradley-Terry, le DPO démontré et vérifié numériquement, le raisonnement avec des récompenses vérifiables, le problème de la mauvaise récompense.
https://www.electronics-engineering.com/fr/applications-de-l-ar-jeux-robotique-conduite-rlhf-dpo/
L’apprentissage par renforcement a quitté les laboratoires en quelques années : il a battu les champions de go et de jeux vidéo complexes, il fait marcher et voler des robots, il pilote des installations, et aujourd’hui il est une partie essentielle de l’entraînement des grands modèles de langage. Cette leçon passe en revue les applications les plus importantes, dit honnêtement où l’AR fonctionne et où il ne fonctionne pas, et démontre les formules du RLHF (reinforcement learning from human feedback) et du DPO, la méthode qui a simplifié sa dernière étape.
Les jeux : là où tout a commencé
- AlphaGo (DeepMind) a battu Lee Sedol 4 à 1 en mars 2016 : des réseaux de neurones entraînés d’abord par imitation sur les parties des maîtres, puis par auto-jeu, avec une recherche arborescente de Monte Carlo. AlphaZero (2017) a supprimé l’imitation : seulement les règles et l’auto-jeu, et il a dépassé les meilleurs programmes d’échecs, de shogi et de go.
- OpenAI Five a battu les champions du monde de Dota 2 en 2019, et AlphaStar a atteint le niveau Grand Maître à StarCraft II : des jeux à information incomplète, des milliers d’actions et de longues parties, abordés avec PPO et ses variantes sur des milliers de processeurs.
Les jeux sont le cas idéal : le simulateur est le jeu lui-même, parfait et très rapide, et la récompense (gagner) est claire.
Robotique et contrôle
- Locomotion : des robots quadrupèdes (comme l’ANYmal de l’ETH Zurich) et des humanoïdes marchent sur des terrains difficiles avec des politiques entraînées en simulation avec des milliers de copies parallèles et la randomisation de domaine, puis transférées au robot réel sans entraînement supplémentaire.
- Drones : en 2023, le système Swift de l’Université de Zurich, entraîné par AR en simulation, a battu des champions humains de course de drones (un résultat publié dans Nature).
- Installations : DeepMind a utilisé l’AR pour le refroidissement des centres de données de Google, en annonçant une réduction pouvant aller jusqu’à 40 % de l’énergie utilisée pour le refroidissement, et en 2022, avec l’EPFL, pour contrôler la forme du plasma dans le tokamak TCV en agissant sur 19 bobines magnétiques.
Le problème commun est le transfert de la simulation à la réalité, traité dans la leçon précédente, et la sécurité : un contrôleur appris est difficile à certifier, et on l’associe presque toujours à un contrôleur classique ou à un filtre de sécurité qui empêche les actions dangereuses.
Conduite autonome et ADAS
Dans les voitures, l’AR est utilisé avec prudence. Les fonctions ADAS en série (freinage d’urgence, maintien dans la voie, régulateur de vitesse adaptatif) reposent sur le contrôle classique, comme celui du cours de Projet de systèmes automatiques, et sur des réseaux de neurones supervisés pour la perception. L’AR est étudié surtout pour les décisions : quand changer de voie, comment s’insérer dans un flux, comment se comporter aux carrefours avec les autres usagers. La conduite « de bout en bout », de la caméra au volant, repose surtout sur l’imitation de millions de kilomètres de conduite humaine, l’AR servant à corriger en simulation des comportements rares et dangereux. La raison est la sécurité : dans une voiture, on ne peut pas explorer, et la validation exige de démontrer le comportement dans chaque situation.
Les modèles de langage : le RLHF
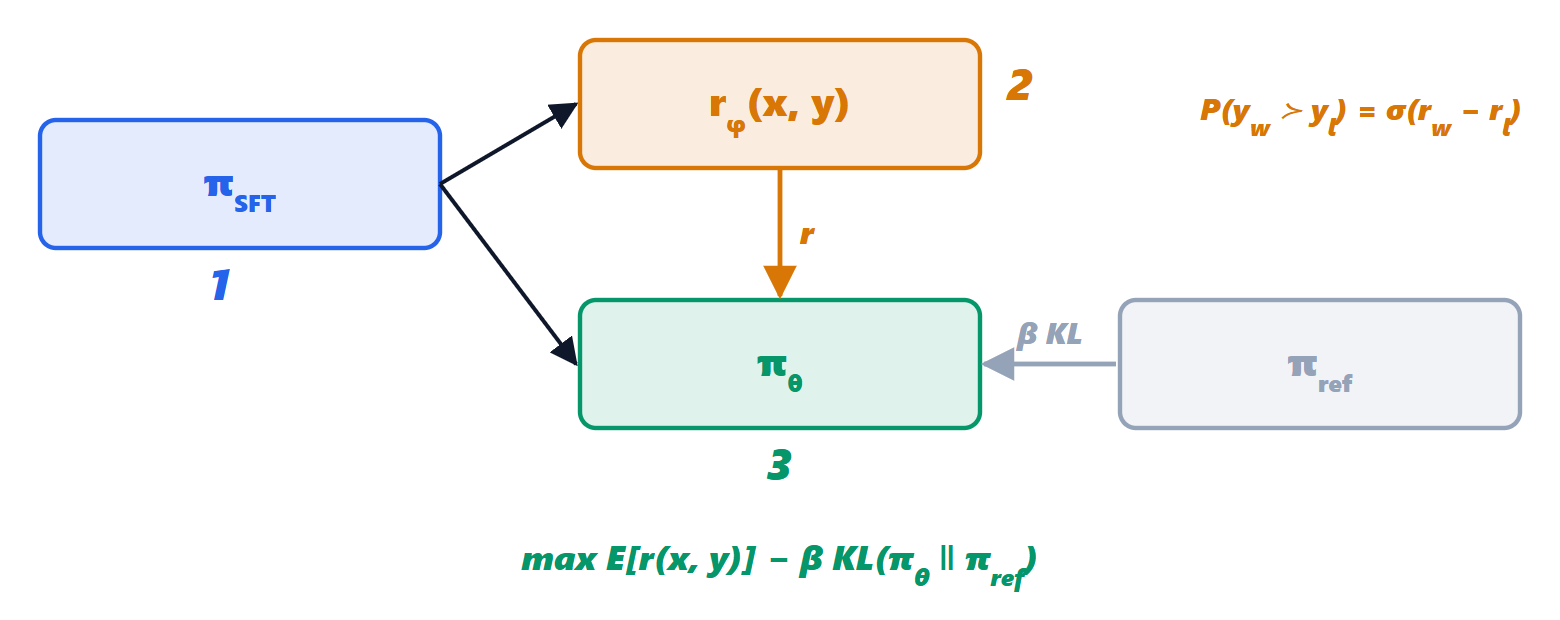
Un modèle de langage pré-entraîné sait poursuivre un texte, mais ne sait pas forcément être utile, honnête et inoffensif. Le RLHF (reinforcement learning from human feedback), rendu célèbre par InstructGPT (OpenAI, 2022), l’entraîne en trois étapes :
1. Imitation (réglage fin supervisé) : le modèle apprend à partir de réponses d’exemple écrites par des personnes. C’est du clonage de comportement.
2. Modèle de récompense : pour la même question  , on génère deux réponses, et une personne choisit la meilleure
 par rapport à l’autre
 . Un réseau
 apprend à donner un score cohérent avec les préférences, avec le modèle de Bradley-Terry :
 , avec
 la sigmoïde ; on minimise
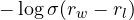 .
3. Renforcement : le modèle (la politique  , qui « agit » en choisissant des mots) est optimisé avec PPO pour maximiser la récompense, mais sans trop s’éloigner du modèle de départ
 :

Le terme de Kullback-Leibler empêche le modèle de trouver des réponses étranges qui « trompent » le modèle de récompense (qui n’est qu’une approximation des vraies préférences). Dans le travail d’InstructGPT, les réponses d’un modèle de 1,3 milliard de paramètres entraîné de cette façon étaient préférées par les personnes à celles du GPT-3 de 175 milliards.
DPO : les préférences sans PPO
PPO sur un modèle à des milliards de paramètres est coûteux et délicat. Le DPO (direct preference optimization, Rafailov et al., 2023) montre que la troisième étape peut se faire avec une simple fonction de perte supervisée.
Théorème. La politique qui maximise  est
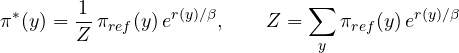
Démonstration. On réécrit l’objectif en mettant  en facteur :
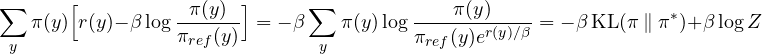
 ne dépend pas de
 , et la divergence KL est non négative et nulle seulement si
 (inégalité de Gibbs) : le maximum est . ∎
En inversant :  . La récompense est déterminée par la politique optimale à une constante près, qui dans le modèle de Bradley-Terry s’annule (seule la différence
 compte). En substituant, on obtient une fonction de perte qui entraîne la politique directement sur des paires de préférences, sans modèle de récompense et sans AR :
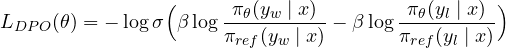
Vérification numérique. Avec quatre réponses possibles, 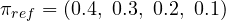 , des récompenses
 et
 , la formule donne
 ; la descente de gradient sur l’objectif atteint les mêmes valeurs à la quatrième décimale, avec un objectif de 2,046 contre 1,3 pour la politique de départ, et à partir de
 , les différences de récompense
 sont reconstruites exactement.
import numpy as np

pi_ref = np.array([0.4, 0.3, 0.2, 0.1])                    # reference policy over four answers
r = np.array([1.0, 2.0, 0.0, 3.0])                         # rewards
beta = 0.5

pi_star = pi_ref * np.exp(r / beta)                        # closed form
pi_star /= pi_star.sum()

z = np.log(pi_ref).copy()                                  # gradient descent on the logits
for _ in range(20000):
    p = np.exp(z - z.max()); p /= p.sum()
    f = r - beta * (np.log(p) - np.log(pi_ref))
    z += 0.5 * p * (f - (p * f).sum())
p = np.exp(z - z.max()); p /= p.sum()

objective = lambda q: (q * r).sum() - beta * (q * np.log(q / pi_ref)).sum()
print("closed form:", np.round(pi_star, 4), " gradient:", np.round(p, 4))
print("objective:", round(objective(pi_star), 4), "against", round(objective(pi_ref), 4))
rr = beta * np.log(pi_star / pi_ref)                       # reward recovered from the policy
print("reward differences:", np.round(rr - rr[0], 4))
Le raisonnement avec des récompenses vérifiables
Depuis 2024, l’AR sert aussi à apprendre aux modèles à raisonner : sur des problèmes de mathématiques et de programmation, la réponse peut être vérifiée automatiquement (le résultat est juste, le programme passe les tests), et la vérification devient la récompense. Le modèle génère de nombreuses tentatives, les correctes sont renforcées. DeepSeek-R1 (2025) a montré que de longues chaînes de raisonnement, avec des autocorrections, émergent ainsi, avec une variante de PPO sans critique (GRPO, qui estime l’avantage en comparant les tentatives d’un même groupe).
Quand l’AR tourne mal : la mauvaise récompense
Un agent maximise la récompense qu’on lui donne, non celle qui était voulue. Dans un célèbre exemple d’OpenAI (2016), un agent entraîné à un jeu de course de bateaux, récompensé pour avoir touché des cibles, a découvert que tourner en rond en touchant sans cesse les mêmes cibles rapportait plus que terminer la course. Dans les systèmes réels, ce phénomène (reward hacking, specification gaming) est la principale préoccupation : on le combat avec des récompenses soigneusement conçues, des contraintes explicites, des limites à l’écart par rapport à un comportement connu (comme le terme KL du RLHF) et des contrôles indépendants du comportement final.
Résumé
| domaine | pourquoi ça marche | difficulté principale |
|---|---|---|
| jeux | simulateur parfait et rapide, récompense claire | espace d’actions énorme |
| robotique | simulateurs GPU, randomisation de domaine | transfert à la réalité, sécurité |
| installations | modèles et données historiques abondants | certification, contraintes |
| conduite autonome | imitation sur de grandes données, AR en simulation | validation, événements rares |
| modèles de langage | préférences humaines et contrôles automatiques | récompense approximative, reward hacking |




Ciao, sono l'autore di «Applicazioni dell’RL: giochi, robotica, guida autonoma, RLHF e DPO per i modelli linguistici». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “RL applications: games, robotics, autonomous driving, RLHF and DPO for language models”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.