Les équations de Bellman démontrées : contraction, itération de valeur et itération de politique
Équation de Bellman pour une politique et équation d'optimalité, l'opérateur de Bellman est une contraction (avec démonstration), existence et unicité de la valeur optimale, théorème d'amélioration de la politique, code Python sur le monde en grille.
https://www.electronics-engineering.com/fr/equations-de-bellman-contraction-iteration-de-valeur-et-de-politique/
Les équations de Bellman sont le cœur mathématique de l’apprentissage par renforcement : elles transforment la définition de la valeur, une moyenne sur une infinité de futurs possibles, en une équation qui relie la valeur d’un état à celle des états suivants. Tous les algorithmes en découlent, des exacts (itération de valeur et de politique) à ceux qui apprennent de l’expérience (Q-learning, DQN, acteur-critique). Cette leçon les établit, démontre qu’elles ont une et une seule solution et que les algorithmes convergent, et les applique au monde en grille de la leçon précédente avec du code Python.
L’équation de Bellman pour une politique
Théorème. Pour toute politique  et tout état
 :
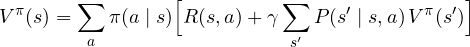
Démonstration. On part de la relation récursive du retour, 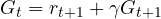 , et l’on prend la moyenne conditionnée par
 :
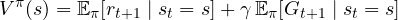
Le premier terme est la récompense moyenne :  est choisi avec la probabilité
 et l’on reçoit en moyenne
 . Dans le second, on conditionne aussi par l’état suivant : par la propriété de Markov, une fois
 connu, le futur ne dépend pas de la façon dont on y est arrivé, donc
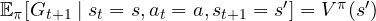 . En pondérant par les probabilités
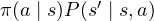 , on obtient l’équation. ∎
C’est un système linéaire de  équations à inconnues : sous forme vectorielle
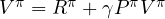 , de solution
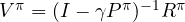 (la matrice est inversible pour
 , parce que
 a une norme inférieure à 1). Pour le monde en grille avec la politique aléatoire, cela donne les valeurs −14, −20, −22 de la leçon précédente.
L’équation d’optimalité
Pour la politique optimale, la moyenne sur les actions devient un maximum :
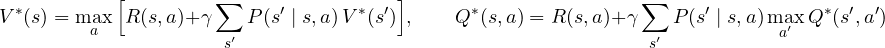
Elle n’est plus linéaire (à cause du maximum), donc elle ne se résout pas en inversant une matrice : elle se résout par itération. Le résultat qui le rend possible est le suivant.
La contraction de Bellman
On définit l’opérateur de Bellman optimal  , qui transforme une fonction
 en une autre :
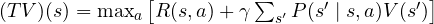 . L’équation d’optimalité dit que
 est un point fixe :
 .
Théorème. est une contraction de facteur  pour la norme du maximum : pour tous
 ,
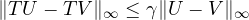 .
Démonstration. On utilise une inégalité élémentaire : pour deux fonctions  de ,
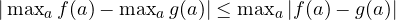 (si le maximum de
 est en
 ,
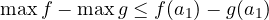 , et symétriquement). Alors, pour tout :
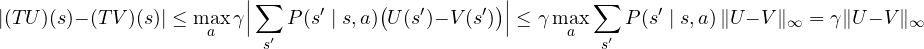
parce que les probabilités  ont pour somme 1. ∎
Conséquences (théorème du point fixe de Banach) :
- le point fixe existe et est unique : est bien défini ;
- en partant de n’importe quel
 , la suite
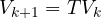 converge vers , et l’erreur diminue au moins du facteur à chaque pas :
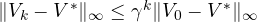 .
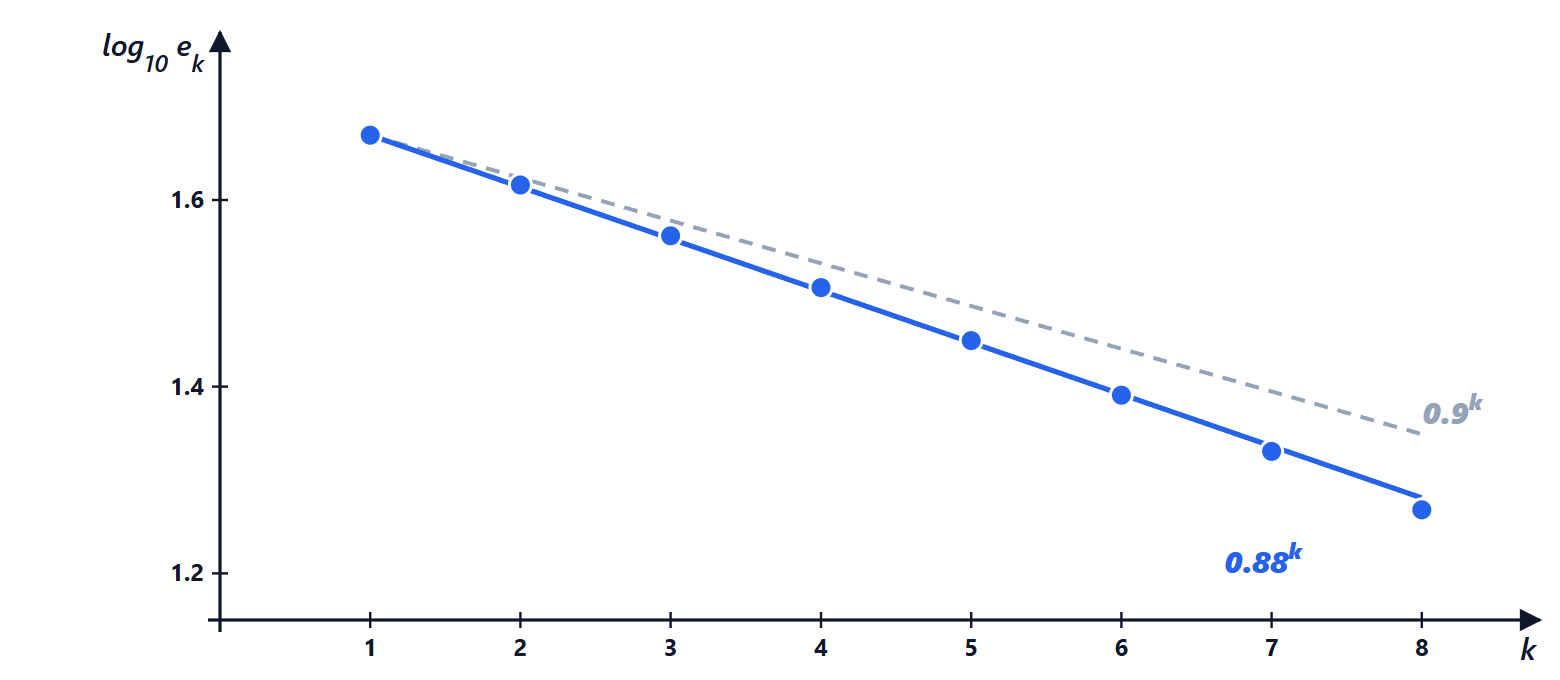
C’est l’itération de valeur. Sur le monde en grille avec  et une estimation initiale volontairement fausse (50 dans chaque case), l’erreur maximale passe de 46,7 à 41,3, 36,5, 32,1, … : des rapports entre 0,87 et 0,88, toujours inférieurs à 0,9 comme le garantit le théorème.
L’amélioration de la politique
Théorème (amélioration de la politique). Étant donnée une politique , soit  la politique gloutonne par rapport à
 :
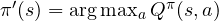 . Alors
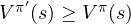 pour tout .
Démonstration. Par construction, 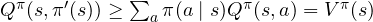 . On développe
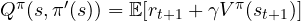 en prenant au premier pas, et l’on applique la même inégalité à
 :
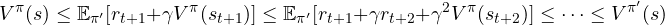
en répétant à l’infini (les termes résiduels  tendent vers zéro). ∎
Alterner l’évaluation (calculer  avec l’équation linéaire) et l’amélioration (rendre la politique gloutonne) donne l’itération de politique : chaque pas améliore la politique ou la laisse inchangée, les politiques déterministes sont en nombre fini, donc en un nombre fini de pas on arrive à une politique qui ne s’améliore plus, c’est-à-dire qui vérifie l’équation d’optimalité. Cela démontre aussi qu’il existe toujours une politique optimale déterministe. Le schéma « évaluer, puis améliorer » revient dans tous les algorithmes modernes : dans l’acteur-critique, le critique évalue et l’acteur améliore.
Le code
import numpy as np

N = 4                                         # 4x4 gridworld, exits at 0 and 15, -1 per step
MOVES = [(-1, 0), (1, 0), (0, -1), (0, 1)]    # up, down, left, right
EXITS = {0, 15}

def step(s, a):
    if s in EXITS:
        return s, 0.0
    r, c = divmod(s, N)
    r = min(max(r + MOVES[a][0], 0), N - 1)
    c = min(max(c + MOVES[a][1], 0), N - 1)
    return r * N + c, -1.0

def bellman_optimal(V, gamma):
    """Optimal Bellman operator T: (TV)(s) = max_a [ r + gamma V(s') ]."""
    return np.array([0.0 if s in EXITS else
                     max(r + gamma * V[s2] for s2, r in (step(s, a) for a in range(4)))
                     for s in range(N * N)])

# value iteration with gamma = 1
V = np.zeros(N * N)
for k in range(100):
    V_new = bellman_optimal(V, 1.0)
    if np.max(abs(V_new - V)) < 1e-10:
        break
    V = V_new
print("V* after", k, "sweeps:\n", V.reshape(N, N))

# evaluation of the random policy: average over the four actions instead of the maximum
Vr = np.zeros(N * N)
for _ in range(5000):
    Vr = np.array([0.0 if s in EXITS else
                   np.mean([r + Vr[s2] for s2, r in (step(s, a) for a in range(4))])
                   for s in range(N * N)])
print("random policy:\n", np.round(Vr.reshape(N, N), 1))

# greedy policy with respect to V*: the best arrow in each cell
ARROWS = "↑↓←→"
pol = [" " if s in EXITS else ARROWS[int(np.argmax([r + V[s2] for s2, r in (step(s, a) for a in range(4))]))]
       for s in range(N * N)]
print("\n".join(" ".join(pol[i * N:(i + 1) * N]) for i in range(N)))

# contraction: with gamma = 0.9 the error shrinks at least by 0.9 per sweep
Vs = np.zeros(N * N)
for _ in range(200):
    Vs = bellman_optimal(Vs, 0.9)
U = np.where(np.isin(np.arange(N * N), list(EXITS)), 0.0, 50.0)
errors = []
for _ in range(6):
    U = bellman_optimal(U, 0.9)
    errors.append(np.max(abs(U - Vs)))
print("errors:", np.round(errors, 2), "ratios:", np.round(np.array(errors[1:]) / np.array(errors[:-1]), 3))
L’exécution affiche après 3 balayages plus celui de contrôle (les valeurs 0, −1, −2, −3), les valeurs de la politique aléatoire (−14, −18, −20, −22), la grille de flèches vers la sortie la plus proche et les erreurs 46,71, 41,31, 36,45, … avec des rapports 0,884, 0,882, 0,880, … Sur de grands problèmes, le tableau  ne tient pas en mémoire et
 est inconnue : les leçons suivantes remplacent la somme sur
 par l’expérience (Q-learning) et le tableau par un réseau de neurones (DQN).



Sono l'autore di questa pagina su «Le equazioni di Bellman dimostrate: contrazione, iterazione dei valori e della policy». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “The Bellman equations proved: contraction, value iteration and policy iteration”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.