Processus de décision markoviens : agent, environnement, retour, politique et fonctions de valeur
Le langage de l'apprentissage par renforcement : la boucle agent-environnement, la propriété de Markov, retour et actualisation, politique, valeur d'état et d'action, avantage, le monde en grille avec politique aléatoire et optimale.
https://www.electronics-engineering.com/fr/processus-de-decision-markoviens-retour-politique-fonctions-de-valeur/
Dans l’apprentissage supervisé, quelqu’un fournit la bonne réponse pour chaque exemple. Dans l’apprentissage par renforcement (AR), personne ne la connaît : un agent essaie des actions dans un environnement, reçoit une récompense numérique et doit apprendre tout seul quel comportement la maximise à long terme. C’est ainsi que l’on entraîne des programmes qui jouent mieux que les champions (AlphaGo), des robots qui marchent, des régulateurs de trafic et l’étape finale des grands modèles de langage (RLHF). Cette première leçon définit le langage mathématique de tout le cours : le processus de décision markovien, le retour, la politique et les fonctions de valeur.
L’agent et l’environnement
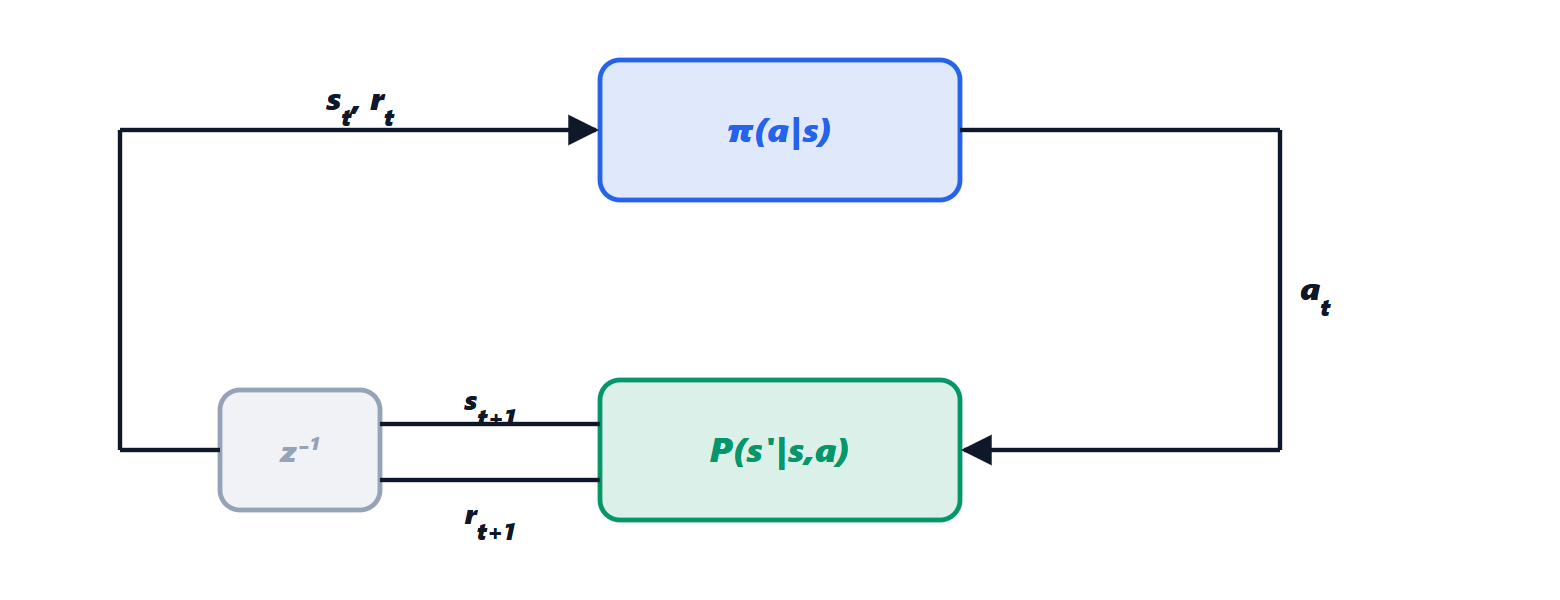
À chaque instant 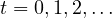 , l’agent observe l’état
 , choisit une action
 , et l’environnement répond par une récompense
 et un nouvel état
 . La boucle se répète. Pour un robot, l’état est les positions et les vitesses des articulations, l’action les couples des moteurs, la récompense un nombre qui récompense l’avancée sans tomber. Pour CartPole, l’exemple que nous utiliserons souvent, l’état est la position et la vitesse du chariot, l’angle et la vitesse angulaire du bâton, l’action est de pousser à gauche ou à droite, et la récompense est +1 à chaque pas où le bâton reste debout.
Le processus de décision markovien
Un MDP (Markov decision process) est le quintuplet 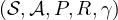 :
 l’ensemble des états,
 celui des actions ;
 la probabilité de passer à
 en prenant
 dans
 ;
 la récompense moyenne obtenue en prenant dans ;
 le facteur d’actualisation.
Le mot markovien indique l’hypothèse fondamentale : le futur ne dépend du passé que par l’état présent,  . Si l’observation ne contient pas tout le nécessaire (par exemple une seule image d’une balle, qui ne dit pas sa vitesse), on le retrouve en mettant aussi les observations précédentes dans l’état ou en utilisant des réseaux à mémoire.
Le retour et l’actualisation
Le but n’est pas la récompense immédiate mais le retour, la somme des récompenses futures actualisées :
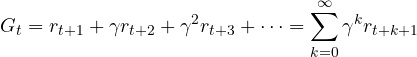
L’actualisation a trois raisons. Mathématique : si les récompenses sont bornées par  et
 , la série géométrique converge,
 . Pratique : une récompense lointaine est plus incertaine. D’interprétation :
 est l’horizon sur lequel l’agent « regarde » : avec
 , environ 100 pas. La relation récursive, base de tout le cours, vaut :
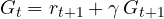
Politique et fonctions de valeur
Une politique  est la règle par laquelle l’agent choisit : la probabilité de prendre dans l’état (déterministe si elle donne toujours la même action). Pour l’évaluer, on définit :
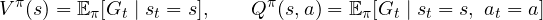
 , la valeur de l’état, est le retour moyen en partant de et en suivant
 ;
 , la valeur de l’action, est le retour moyen en prenant d’abord puis en suivant . Elles sont liées par
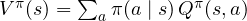 . La différence
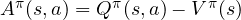 s’appelle l’avantage : de combien l’action est meilleure que la moyenne. Tous les algorithmes modernes l’utilisent.
Une politique  est optimale si
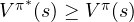 dans tout état, pour toute autre . Dans un MDP fini, il existe toujours une politique optimale déterministe (on le démontre dans la leçon sur les équations de Bellman), et en connaissant
 elle est immédiate :
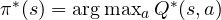 .
Un exemple complet : le monde en grille
Une grille 4×4 ; les cases en haut à gauche et en bas à droite sont les sorties. L’agent se déplace d’une case vers le haut, le bas, la gauche ou la droite (s’il heurte le bord, il reste sur place), et chaque pas coûte  : maximiser le retour veut dire sortir le plus vite possible. Avec
 :
- pour la politique optimale, la valeur de chaque case est moins le nombre de pas jusqu’à la sortie la plus proche : 0, −1, −2, −3 ;
- pour la politique aléatoire (chaque direction avec une probabilité 1/4), les valeurs sont bien plus négatives : −14 près des sorties, −22 dans les coins éloignés, parce que la marche aléatoire erre longtemps avant de sortir.
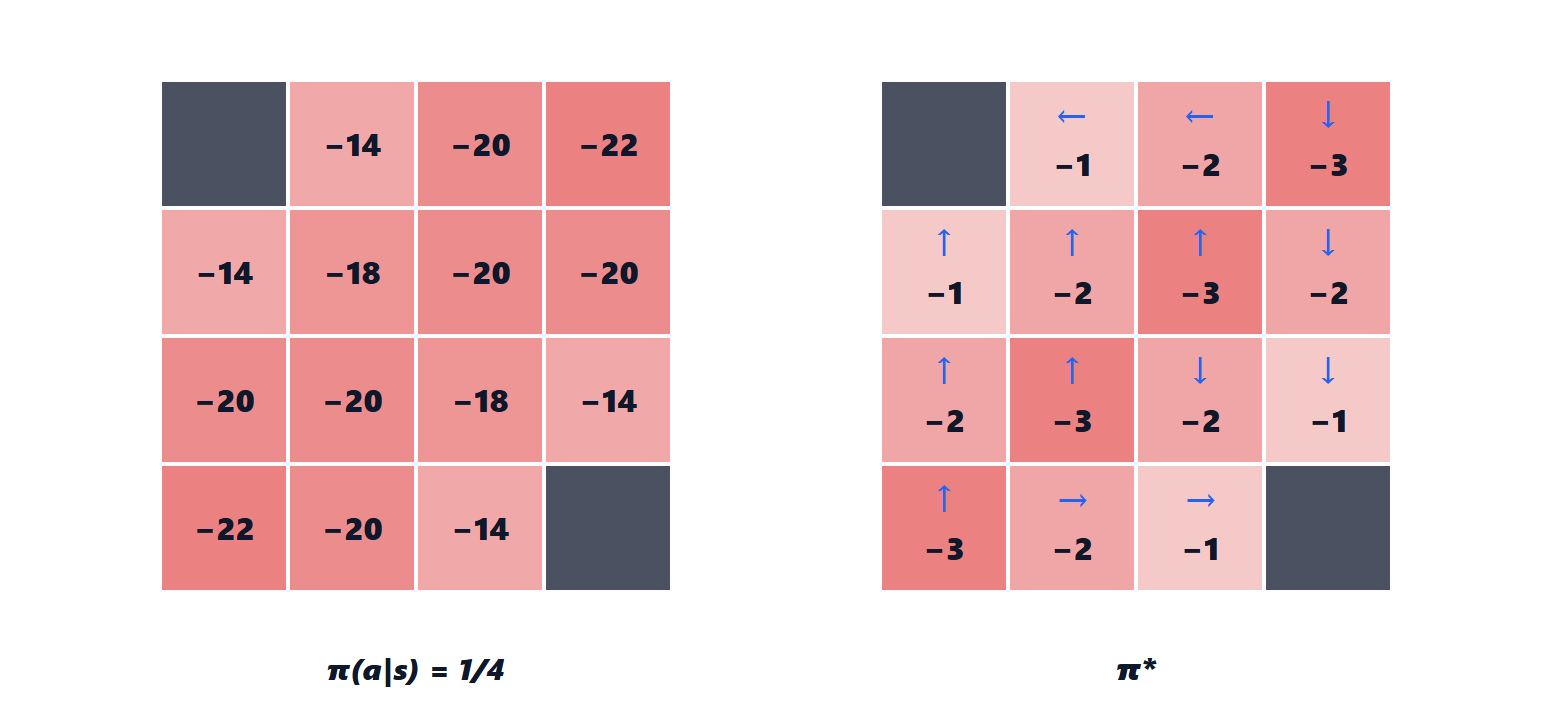
Le fait que la politique aléatoire vaille −22 dans un coin, et l’optimale −3, montre le point central de l’AR : à partir des mêmes états et des mêmes actions, le comportement choisi change radicalement le résultat. La leçon suivante montre comment calculer ces valeurs, et à partir d’elles la politique optimale, avec les équations de Bellman ; les leçons d’après, comment les apprendre quand  et
 sont inconnues et que l’état est trop grand pour un tableau.
Où se situe l’AR parmi les techniques de contrôle
Ceux qui ont étudié les Contrôles automatiques reconnaîtront la structure : l’état, l’entrée (l’action), la dynamique (), un indice de coût à optimiser ( ). Le contrôle optimal (LQR, MPC) résout le même problème en connaissant le modèle ; l’AR le résout en apprenant de l’expérience, même quand il n’y a pas de modèle ou qu’il est trop compliqué. Le prix est le nombre d’essais : c’est pourquoi l’AR se fait presque toujours en simulation, et la vitesse des simulateurs (leçon sur les bibliothèques) est décisive.




Benvenuti nella pagina su «Processi decisionali di Markov: agente, ambiente, ritorno, policy e funzioni valore». L'ho scritta pensando a chi studia ingegneria elettronica: se un passaggio non vi torna, un esercizio vi dà un risultato diverso o volete altro materiale sull'argomento, chiedete pure nei commenti e vi risponderò. Un voto con le stelle qui sopra mi aiuta a capire quali pagine migliorare.Welcome to the page on “Markov decision processes: agent, environment, return, policy and value functions”. I wrote it for engineering students: if a step does not add up, an exercise gives you a different result or you would like more material on the topic, just ask in the comments and I will reply. A star rating above helps me understand which pages to improve.