Approximation aux moindres carrés et régression
Le problème des moindres carrés, équations normales, étalonnage d'un capteur, forme matricielle et QR, modèles linéaires dans les paramètres, résidus et surapprentissage.
https://www.electronics-engineering.com/fr/moindres-carres-regression/
Les mesures réelles sont bruitées : forcer une courbe à passer par chaque point, comme le fait l’interpolation, revient à suivre aussi les erreurs. La méthode des moindres carrés, inventée par Gauss et Legendre au début du XIXe siècle pour calculer les orbites des planètes, cherche au contraire la courbe d’une forme donnée qui passe le plus près possible de tous les points ensemble. C’est ainsi qu’on étalonne des capteurs, qu’on estime les paramètres d’un modèle et qu’on trace la droite de tendance de tout graphique.
Le problème
Étant donnés  points
 , on cherche une fonction d’une famille choisie, par exemple une droite
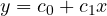 , qui minimise la somme des carrés des résidus :
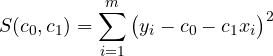
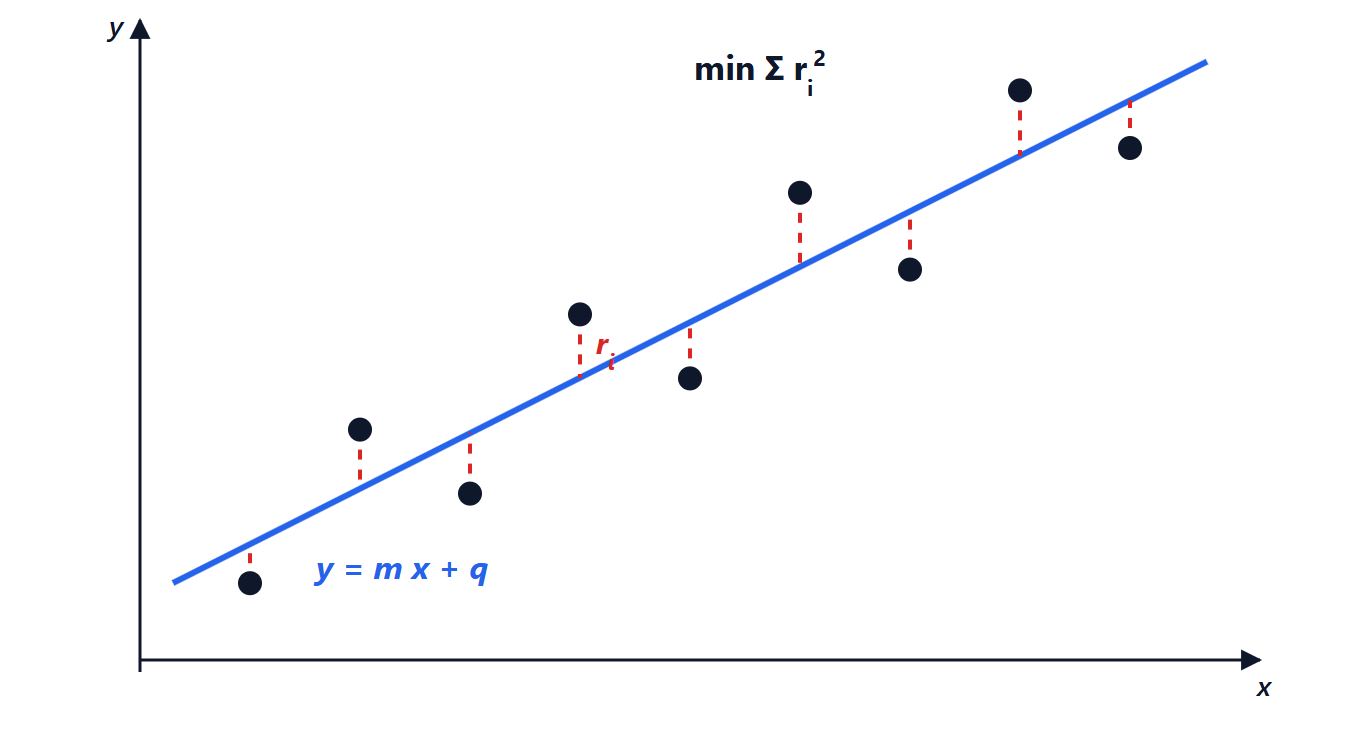
 (en rouge pointillé).
Pourquoi des carrés et pas des valeurs absolues ? Parce que la fonction à minimiser devient lisse, le minimum se trouve avec des dérivées et conduit à un système linéaire ; et parce que, si les erreurs de mesure sont gaussiennes, la solution est aussi l’estimation la plus probable des paramètres.
Les équations normales
En annulant les dérivées partielles (leçon d’Analyse 2 sur les maxima et minima) :
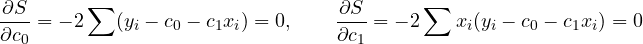
c’est-à-dire
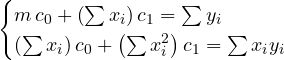
de solution
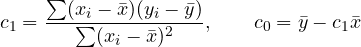
où  et
 sont les moyennes. La droite passe toujours par le centre de gravité des points
 .
Exemple : étalonner un capteur. Un capteur de température donne les tensions 0.52, 0.71, 0.88, 1.11, 1.29 V à 0, 20, 40, 60, 80 °C. Les moyennes sont  °C et
 V. Les écarts aux moyennes sont
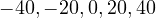 pour les températures et
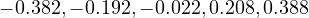 pour les tensions, donc
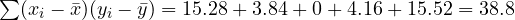 et
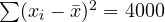 . La sensibilité est
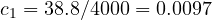 V/°C, soit 9.7 mV/°C, et le décalage
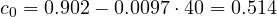 V. Le modèle donne 0.514, 0.708, 0.902, 1.096, 1.290 V : les résidus sont de quelques millivolts, le plus grand de 22 mV à 40 °C.
La forme matricielle
Le problème s’écrit  , où
 a une ligne par mesure et une colonne par paramètre (pour la droite, les colonnes sont formées de 1 et des
 ). C’est un système avec plus d’équations que d’inconnues, en général sans solution exacte. La solution aux moindres carrés satisfait les équations normales
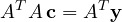
et, comme on l’a vu en Géométrie et Algèbre,  est la projection orthogonale de
 sur l’espace engendré par les colonnes de : le vecteur résidu est perpendiculaire à chaque colonne.
Avertissement numérique. Former  élève au carré le nombre de conditionnement : si
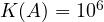 ,
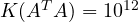 , et on perd 12 chiffres au lieu de 6. Les bibliothèques utilisent plutôt la factorisation QR,
 avec
 à colonnes orthonormées, qui conduit au système triangulaire
 sans dégrader le conditionnement. Pour les problèmes les plus difficiles on utilise la décomposition en valeurs singulières (SVD).
Pas seulement des droites
La méthode fonctionne avec tout modèle linéaire dans les paramètres, même non linéaire en  :
- les polynômes
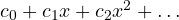 (de bas degré, pour ne pas retomber dans les oscillations de Runge) ;
- les combinaisons de fonctions connues, comme
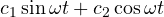 , pour estimer l’amplitude et la phase d’un signal de fréquence connue ;
- les modèles qui deviennent linéaires après une transformation :
 devient
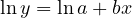 . C’est ainsi qu’on estime la constante de temps d’une décharge RC à partir d’une série de lectures de tension.
Pour les modèles vraiment non linéaires dans les paramètres (par exemple une caractéristique de diode avec résistance série) on utilise des méthodes itératives comme Gauss-Newton et Levenberg-Marquardt, qui linéarisent le modèle à chaque pas, comme Newton le fait pour les équations.
La qualité de l’ajustement
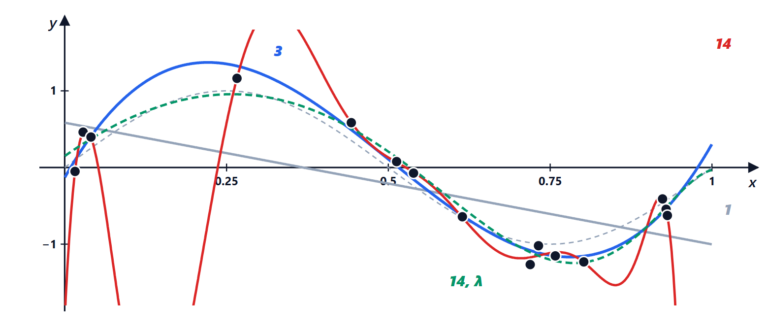
- Les résidus ne doivent montrer aucune structure : s’ils forment une courbe, le modèle est faux (par exemple une droite ajustée à des données quadratiques).
- Le coefficient de détermination
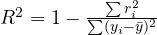 donne la fraction de variabilité expliquée par le modèle : 1 est parfait, 0 signifie que le modèle n’explique rien au-delà de la moyenne.
- Ajouter des paramètres réduit toujours les résidus, mais au-delà d’un certain point le modèle suit le bruit au lieu du phénomène (surapprentissage) : avec points, un polynôme de degré
 a des résidus nuls et est inutile.
Le même principe, minimiser une erreur quadratique sur de nombreuses données, est à la base de l’entraînement des réseaux de neurones : les « poids » sont les paramètres, et le gradient de l’erreur guide leur correction.



Sono l'autore di questa pagina su «Approssimazione ai minimi quadrati e regressione». Se qualcosa non è chiaro, se vi serve un esempio in più o volete approfondire un punto, scrivetelo qui sotto nei commenti: rispondo personalmente. Se la pagina vi è stata utile, lasciate un voto con le stelle in cima all'articolo.I am the author of this page on “Least squares approximation and regression”. If something is unclear, if you need another example or want to go deeper into a point, write it in the comments below: I answer personally. If the page was useful, leave a star rating at the top of the article.