Approssimazione ai minimi quadrati e regressione
Il problema dei minimi quadrati, equazioni normali, calibrazione di un sensore, forma matriciale e QR, modelli lineari nei parametri, residui e overfitting.
Le misure reali sono affette da rumore: costringere una curva a passare per ogni punto, come fa l’interpolazione, vuol dire seguire anche gli errori. Il metodo dei minimi quadrati, inventato da Gauss e Legendre all’inizio dell’Ottocento per calcolare le orbite dei pianeti, cerca invece la curva di una forma data che passa più vicino possibile a tutti i punti insieme. È il metodo con cui si calibrano i sensori, si stimano i parametri dei modelli e si costruisce la retta di tendenza di qualsiasi grafico.
Il problema
Dati  punti
 , si cerca una funzione di una famiglia scelta, per esempio una retta
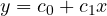 , che renda minima la somma dei quadrati degli scarti:
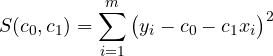
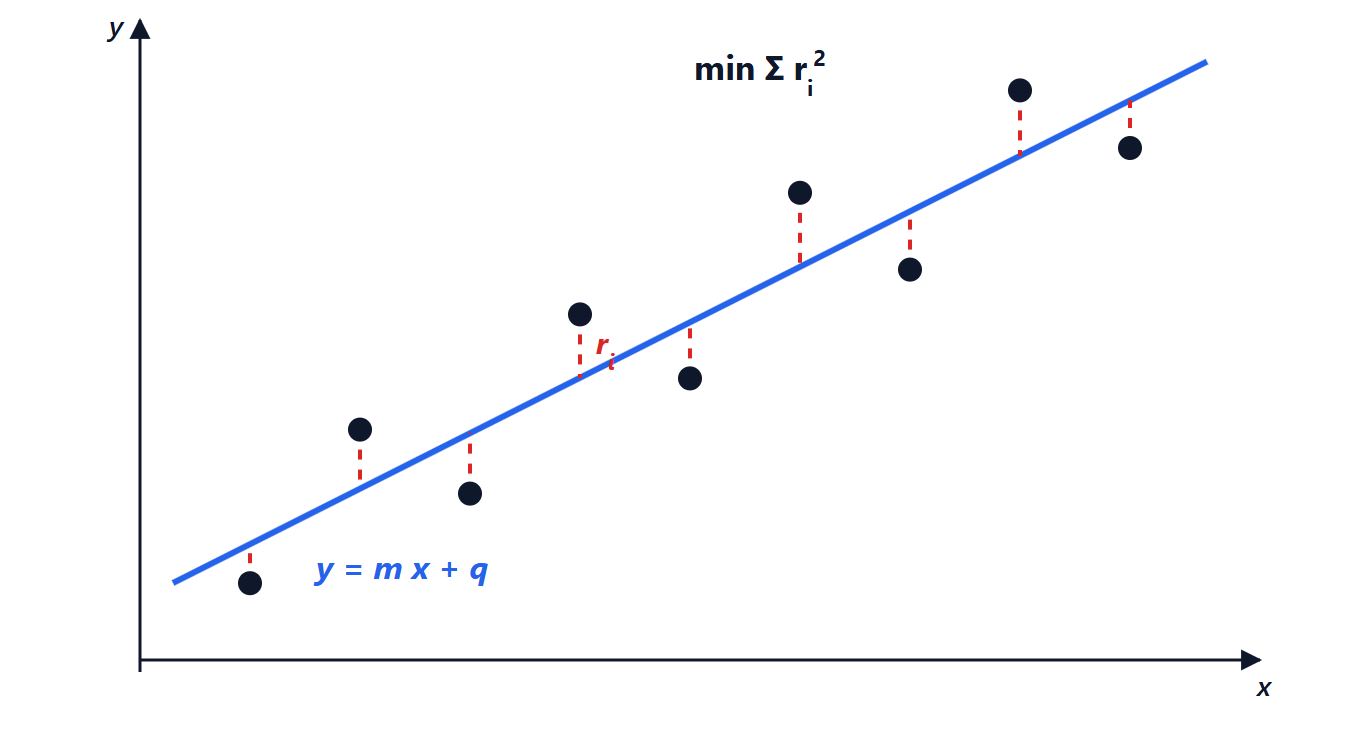
 (rossi tratteggiati).
Perché i quadrati e non i valori assoluti? Perché la funzione da minimizzare diventa liscia, il minimo si trova con le derivate e porta a un sistema lineare; e perché, se gli errori di misura sono gaussiani, la soluzione è anche la stima più probabile dei parametri.
Le equazioni normali
Ponendo a zero le derivate parziali (lezione di Analisi 2 sui massimi e minimi):
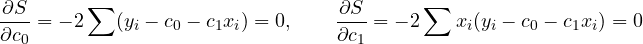
cioè
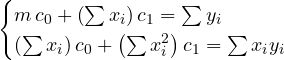
con soluzione
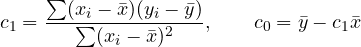
dove  e
 sono le medie. La retta passa sempre per il baricentro dei punti
 .
Esempio: calibrazione di un sensore. Un sensore di temperatura dà le tensioni 0,52; 0,71; 0,88; 1,11; 1,29 V a 0, 20, 40, 60, 80 °C. Le medie sono  °C e
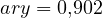 V. Gli scarti dalle medie sono
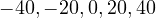 per le temperature e
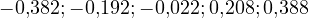 per le tensioni, quindi
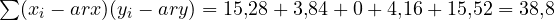 e
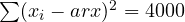 . La sensibilità è
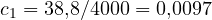 V/°C, cioè 9,7 mV/°C, e l’offset
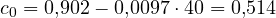 V. Il modello dà 0,514; 0,708; 0,902; 1,096; 1,290 V: gli scarti dalle misure sono di pochi millivolt, il più grande 22 mV a 40 °C.
La forma matriciale
Il problema si scrive  , dove
 ha una riga per ogni misura e una colonna per ogni parametro (per la retta, le colonne sono tutti 1 e gli
 ). È un sistema con più equazioni che incognite, in generale senza soluzione esatta. La soluzione ai minimi quadrati soddisfa le equazioni normali
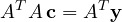
e, come visto in Geometria e Algebra,  è la proiezione ortogonale di
 sullo spazio delle colonne di : il vettore dei residui è perpendicolare a tutte le colonne.
Attenzione numerica. Formare  eleva al quadrato il numero di condizionamento: se
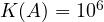 ,
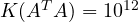 , e si perdono 12 cifre invece di 6. Le librerie usano invece la fattorizzazione QR,
 con
 a colonne ortonormali, che porta al sistema triangolare
 senza peggiorare il condizionamento. Per i problemi più difficili si usa la decomposizione ai valori singolari (SVD).
Non solo rette
Il metodo funziona con qualsiasi modello lineare nei parametri, anche se non lineare in  :
- polinomi
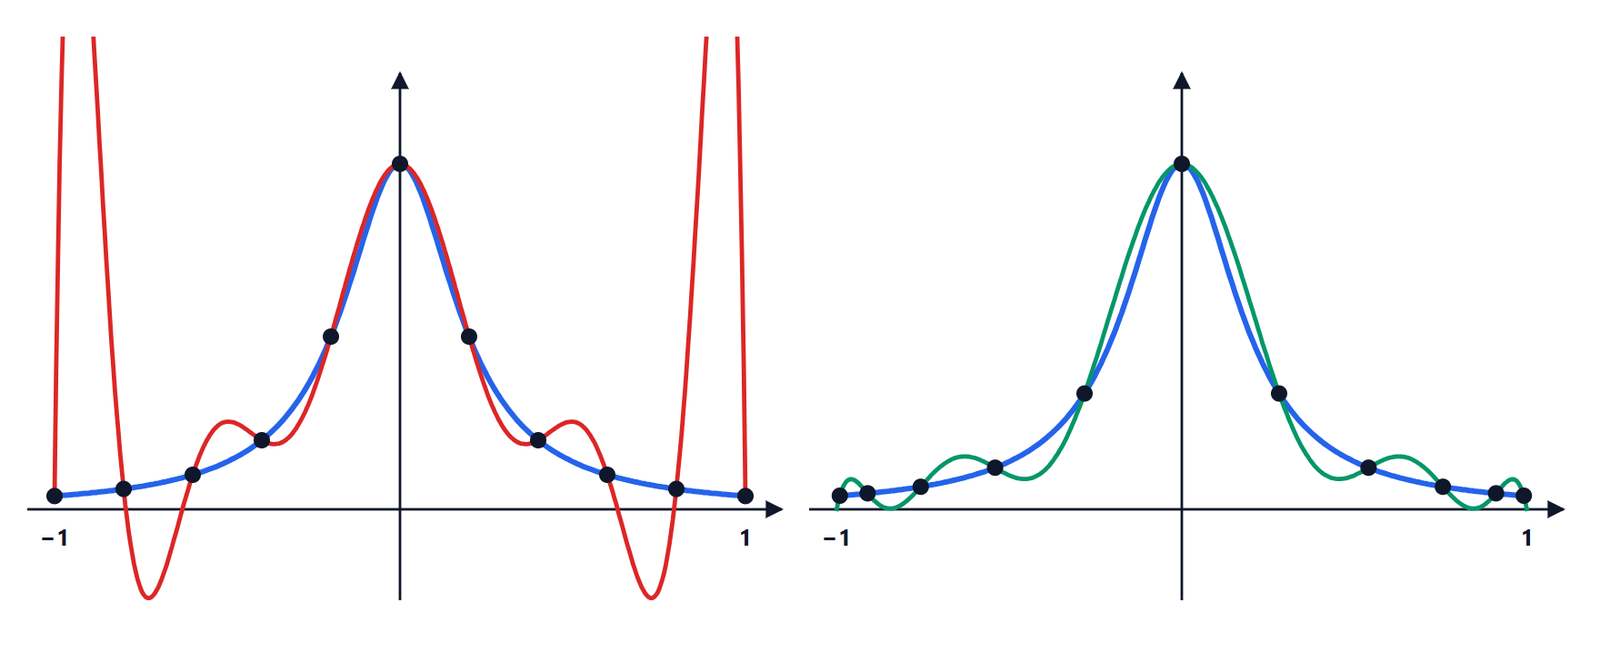
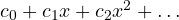 (con grado basso, per non ricadere nelle oscillazioni di Runge);
- combinazioni di funzioni note, come
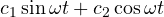 , per stimare ampiezza e fase di un segnale di frequenza nota;
- modelli che diventano lineari con una trasformazione:
 diventa
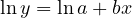 . Così si stima la costante di tempo di una scarica RC da una serie di misure di tensione.
Per i modelli davvero non lineari nei parametri (per esempio la caratteristica di un diodo con la resistenza serie) si usano metodi iterativi come Gauss-Newton e Levenberg-Marquardt, che linearizzano il modello a ogni passo, come Newton per le equazioni.
Quanto è buono il fit
- I residui non devono mostrare un andamento: se formano una curva, il modello è sbagliato (per esempio una retta su dati quadratici).
- Il coefficiente di determinazione
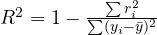 indica la frazione di variabilità spiegata dal modello: 1 è perfetto, 0 vuol dire che il modello non spiega nulla più della media.
- Aggiungere parametri riduce sempre i residui, ma oltre un certo punto il modello segue il rumore invece del fenomeno (overfitting): con punti, un polinomio di grado
 ha residui nulli e non serve a niente.
Lo stesso principio, minimizzare un errore quadratico su molti dati, è alla base dell’addestramento delle reti neurali: i “pesi” sono i parametri, e il gradiente dell’errore guida la loro correzione.