Sistemi lineari al computer: LU, pivoting, Cholesky e metodi iterativi
Fattorizzazione LU e suo costo, pivoting parziale con esempio, Cholesky, matrici sparse, metodi di Jacobi e Gauss-Seidel, raggio spettrale e residuo.
In Geometria e Algebra i sistemi lineari si risolvevano con il metodo di Gauss su matrici 3×3. Nei problemi reali le matrici hanno migliaia o milioni di righe: la simulazione di un circuito integrato, l’analisi strutturale a elementi finiti, la ricostruzione di un’immagine in una TAC. Qui contano il costo del calcolo, la stabilità rispetto agli arrotondamenti e la struttura della matrice. Vediamo i metodi diretti (fattorizzazioni LU e di Cholesky) e quelli iterativi (Jacobi e Gauss-Seidel).
La fattorizzazione LU
L’eliminazione di Gauss, registrando i moltiplicatori usati, scompone la matrice nel prodotto

con  triangolare inferiore (con 1 sulla diagonale e i moltiplicatori sotto) e
 triangolare superiore (la forma a scala). Il sistema
 diventa due sistemi triangolari, che si risolvono per sostituzione:

Il vantaggio. La fattorizzazione costa circa  operazioni, ma le due sostituzioni solo
 . Se si devono risolvere molti sistemi con la stessa matrice e termini noti diversi (come in un simulatore che a ogni passo cambia solo le sorgenti), si fattorizza una volta sola. Con
 :
 operazioni per la fattorizzazione,
 per ogni nuovo termine noto.
Esempio.
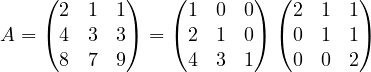
I moltiplicatori 2 e 4 eliminano la prima colonna, il 3 la seconda.
Il pivoting
Se durante l’eliminazione compare uno zero sulla diagonale il metodo si blocca; se compare un numero molto piccolo, si divide per esso e gli errori di arrotondamento esplodono.
Esempio. Con 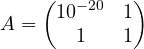 e
 , la soluzione vera è circa
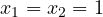 . Senza scambi, il moltiplicatore è
 , e in doppia precisione la seconda riga diventa
 perché
 si arrotonda a
 : si ottiene
 e poi
 , completamente sbagliato. Scambiando le righe prima di eliminare il risultato è corretto.
Il pivoting parziale sceglie a ogni passo, come pivot, l’elemento di modulo massimo della colonna, e scambia le righe. Così i moltiplicatori hanno modulo al massimo 1 e il metodo è stabile nella pratica. La fattorizzazione diventa  , con
 matrice di permutazione. È il metodo standard di tutte le librerie numeriche (LAPACK, NumPy, MATLAB).
Matrici simmetriche definite positive: Cholesky
Se  è simmetrica e definita positiva (come le matrici di rigidezza delle strutture, le matrici di covarianza, le matrici dei nodi dei circuiti fatti solo di resistori), vale

con triangolare inferiore. La fattorizzazione di Cholesky costa la metà della LU ( ), non richiede pivoting ed è sempre stabile. Se durante il calcolo compare la radice di un numero negativo, la matrice non era definita positiva: è anche il modo più rapido di verificarlo.
Matrici sparse
Nelle applicazioni le matrici grandi sono quasi tutte fatte di zeri: nella matrice dei nodi di un circuito, ogni riga ha elementi non nulli solo per i nodi collegati direttamente. Una matrice  piena occuperebbe 8 terabyte in doppia precisione; sparsa, con 10 elementi per riga, 80 megabyte. I metodi diretti per matrici sparse riordinano righe e colonne per limitare il riempimento (fill-in), cioè gli zeri che diventano non nulli durante l’eliminazione. È quello che fanno SPICE e i programmi a elementi finiti.
I metodi iterativi
Per matrici enormi e sparse si preferisce spesso partire da una stima  e migliorarla, senza mai fattorizzare.
Jacobi. Dall’equazione  si ricava
 usando i valori dell’iterazione precedente per le altre incognite:
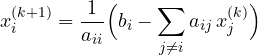
Gauss-Seidel. Come Jacobi, ma usa subito i valori già aggiornati nella stessa iterazione. Di solito converge circa due volte più in fretta e usa meno memoria.
Esempio.  ,
 (soluzione
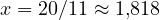 ,
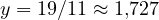 ). Gauss-Seidel da
 :
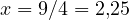 ,
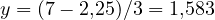 ; poi
 ,
 ; poi
 ,
 . In tre passi, tre cifre corrette.
Quando convergono
Scrivendo l’iterazione come 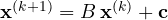 , l’errore viene moltiplicato per
 a ogni passo, quindi il metodo converge se e solo se il raggio spettrale di (il massimo modulo dei suoi autovalori, lezione di Geometria e Algebra) è minore di 1. Una condizione sufficiente facile da verificare: la matrice è a diagonale dominante,
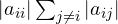 per ogni riga. Le matrici dei nodi dei circuiti resistivi lo sono quasi sempre.
Per i problemi più grandi si usano metodi iterativi più sofisticati, come il gradiente coniugato per le matrici simmetriche definite positive, che in aritmetica esatta arriva alla soluzione in al massimo  passi e nella pratica ne richiede molti meno, soprattutto con un buon precondizionatore.
Il residuo non basta
Dopo aver calcolato  , il residuo
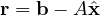 è facile da calcolare, ma un residuo piccolo non garantisce una soluzione accurata. L’errore relativo è limitato da
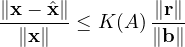
con  il numero di condizionamento della lezione sugli errori. Se è grande, anche un residuo minuscolo può nascondere un errore grande.