Systèmes linéaires sur ordinateur : LU, pivotage, Cholesky et méthodes itératives
Factorisation LU et son coût, pivotage partiel avec un exemple, Cholesky, matrices creuses, méthodes de Jacobi et de Gauss-Seidel, rayon spectral et résidu.
https://www.electronics-engineering.com/fr/systemes-lineaires-numeriques-lu-cholesky-iteratives/
En Géométrie et Algèbre les systèmes linéaires se résolvaient par élimination de Gauss sur des matrices 3×3. Dans les problèmes réels les matrices ont des milliers ou des millions de lignes : simuler un circuit intégré, l’analyse de structures par éléments finis, reconstruire une image dans un scanner. Ce qui compte ici, c’est le coût du calcul, la stabilité vis-à-vis des arrondis et la structure de la matrice. Nous voyons les méthodes directes (factorisations LU et de Cholesky) et itératives (Jacobi et Gauss-Seidel).
La factorisation LU
L’élimination de Gauss, en enregistrant les multiplicateurs utilisés, décompose la matrice en produit

avec  triangulaire inférieure (des 1 sur la diagonale et les multiplicateurs en dessous) et
 triangulaire supérieure (la forme échelonnée). Le système
 devient deux systèmes triangulaires, résolus par substitution :

L’avantage. La factorisation coûte environ  opérations, mais les deux substitutions seulement
 . S’il faut résoudre de nombreux systèmes avec la même matrice et des seconds membres différents (comme dans un simulateur où seules les sources changent à chaque pas), on factorise une seule fois. Avec
 :
 opérations pour la factorisation,
 pour chaque nouveau second membre.
Exemple.
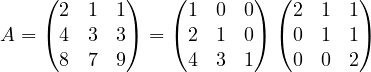
Les multiplicateurs 2 et 4 éliminent la première colonne, le 3 la seconde.
Le pivotage
Si un zéro apparaît sur la diagonale pendant l’élimination la méthode s’arrête ; si un très petit nombre apparaît, on divise par lui et les erreurs d’arrondi explosent.
Exemple. Avec 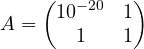 et
 , la vraie solution est environ
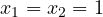 . Sans échanges le multiplicateur est
 , et en double précision la deuxième ligne devient
 parce que
 s’arrondit à
 : on obtient
 puis
 , complètement faux. Échanger les lignes avant d’éliminer donne le bon résultat.
Le pivotage partiel choisit à chaque pas, comme pivot, l’élément de plus grand module de la colonne, et échange les lignes. Les multiplicateurs ont alors un module d’au plus 1 et la méthode est stable en pratique. La factorisation devient  , avec
 une matrice de permutation. C’est la méthode standard de toute bibliothèque numérique (LAPACK, NumPy, MATLAB).
Matrices symétriques définies positives : Cholesky
Si  est symétrique et définie positive (comme les matrices de rigidité des structures, les matrices de covariance, les matrices nodales des circuits de seules résistances), alors

avec triangulaire inférieure. La factorisation de Cholesky coûte moitié moins que LU ( ), n’a pas besoin de pivotage et est toujours stable. Si la racine carrée d’un nombre négatif apparaît pendant le calcul, la matrice n’était pas définie positive : c’est aussi la façon la plus rapide de le vérifier.
Les matrices creuses
Dans les applications, les grandes matrices sont presque entièrement nulles : dans la matrice nodale d’un circuit, chaque ligne n’a des éléments non nuls que pour les nœuds directement connectés. Une matrice pleine  occuperait 8 téraoctets en double précision ; creuse, avec 10 éléments par ligne, 80 mégaoctets. Les méthodes directes creuses réordonnent lignes et colonnes pour limiter le remplissage (fill-in), les zéros qui deviennent non nuls pendant l’élimination. C’est ce que font SPICE et les programmes d’éléments finis.
Les méthodes itératives
Pour de très grandes matrices creuses il vaut souvent mieux partir d’une estimation  et l’améliorer, sans jamais factoriser.
Jacobi. À partir de l’équation  , on résout en
 en utilisant pour les autres inconnues les valeurs de l’itération précédente :
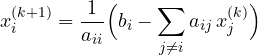
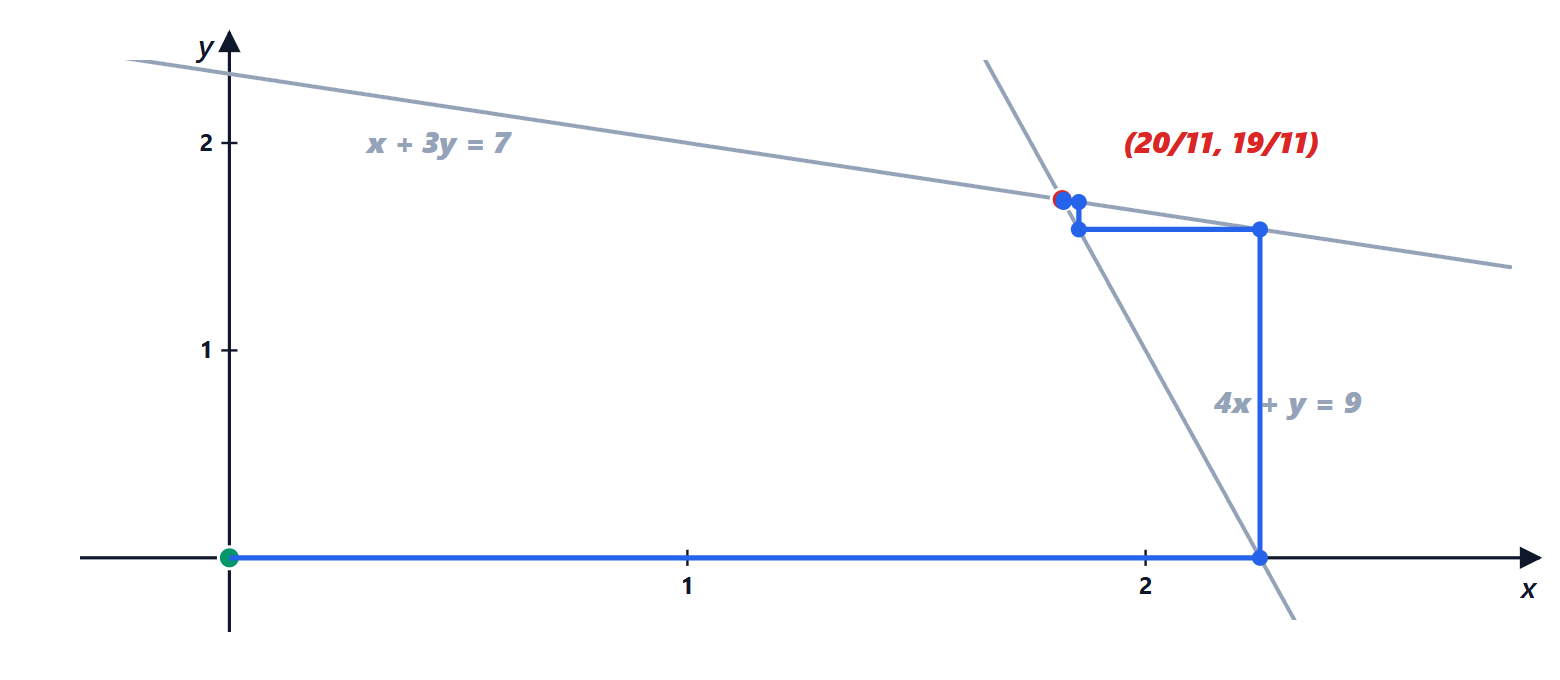
Gauss-Seidel. Comme Jacobi, mais il utilise tout de suite les valeurs déjà mises à jour dans la même itération. Il converge en général environ deux fois plus vite et utilise moins de mémoire.
Exemple.  ,
 (solution
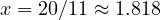 ,
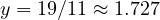 ). Gauss-Seidel à partir de
 :
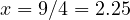 ,
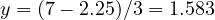 ; puis
 ,
 ; puis
 ,
 . Trois pas, trois chiffres corrects.
Quand elles convergent
En écrivant l’itération sous la forme 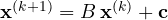 , l’erreur est multipliée par
 à chaque pas, donc la méthode converge si et seulement si le rayon spectral de (le plus grand module de ses valeurs propres, leçon de Géométrie et Algèbre) est inférieur à 1. Une condition suffisante facile à vérifier : la matrice est à diagonale dominante,
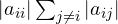 pour chaque ligne. Les matrices nodales des circuits résistifs le sont presque toujours.
Pour les plus gros problèmes on utilise des méthodes itératives plus sophistiquées, comme la méthode du gradient conjugué pour les matrices symétriques définies positives, qui en arithmétique exacte atteint la solution en au plus  pas et en pratique en demande bien moins, surtout avec un bon préconditionneur.
Le résidu ne suffit pas
Après avoir calculé  , le résidu
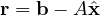 est facile à calculer, mais un petit résidu ne garantit pas une solution précise. L’erreur relative est majorée par
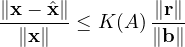
avec  le nombre de conditionnement de la leçon sur les erreurs. Si est grand, même un résidu minuscule peut cacher une grosse erreur.




Ciao, sono l'autore di «Sistemi lineari al computer: LU, pivoting, Cholesky e metodi iterativi». Domande, dubbi, segnalazioni di errori o richieste di approfondimento sono benvenuti: scriveteli qui sotto e vi rispondo io. Potete anche votare la pagina con le stelle all'inizio dell'articolo.Hi, I am the author of “Linear systems on a computer: LU, pivoting, Cholesky and iterative methods”. Questions, doubts, error reports and requests for more detail are all welcome: write them below and I will answer. You can also rate the page with the stars at the top of the article.