Applicazioni lineari: matrice associata, nucleo, immagine e teorema della dimensione
Definizione ed esempi, matrice di un'applicazione con rotazioni e derivata, nucleo e immagine, dimostrazione del teorema della dimensione e cambiamento di base.
Le applicazioni lineari sono le funzioni dell’algebra lineare: trasformano vettori in vettori rispettando somme e multipli. Rotazioni, proiezioni, derivate, filtri digitali sono tutti esempi. In questa lezione vediamo che ogni applicazione lineare tra spazi di dimensione finita si rappresenta con una matrice, introduciamo nucleo e immagine e dimostriamo il teorema della dimensione.
Definizione
Una funzione  tra spazi vettoriali è lineare se
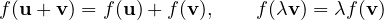
Conseguenza immediata:  . Quindi
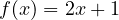 , nonostante il nome di “funzione lineare” che le si dà a scuola, non è lineare in questo senso: è una retta che non passa per l’origine.
Esempi: la rotazione del piano di un angolo  ; la proiezione dello spazio su un piano; la derivata, che manda il polinomio
 in
 e rispetta somme e multipli; un filtro digitale FIR,
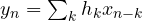 , che è lineare nel segnale d’ingresso.
La matrice di un’applicazione lineare
Un’applicazione lineare è determinata dalle immagini dei vettori di una base. Se 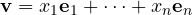 , per la linearità
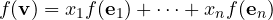
Mettendo come colonne le immagini  si ottiene una matrice
 , e
 . Viceversa, ogni matrice
 definisce un’applicazione lineare da
 a
 . Le colonne di sono le immagini dei vettori della base: è la regola da ricordare.
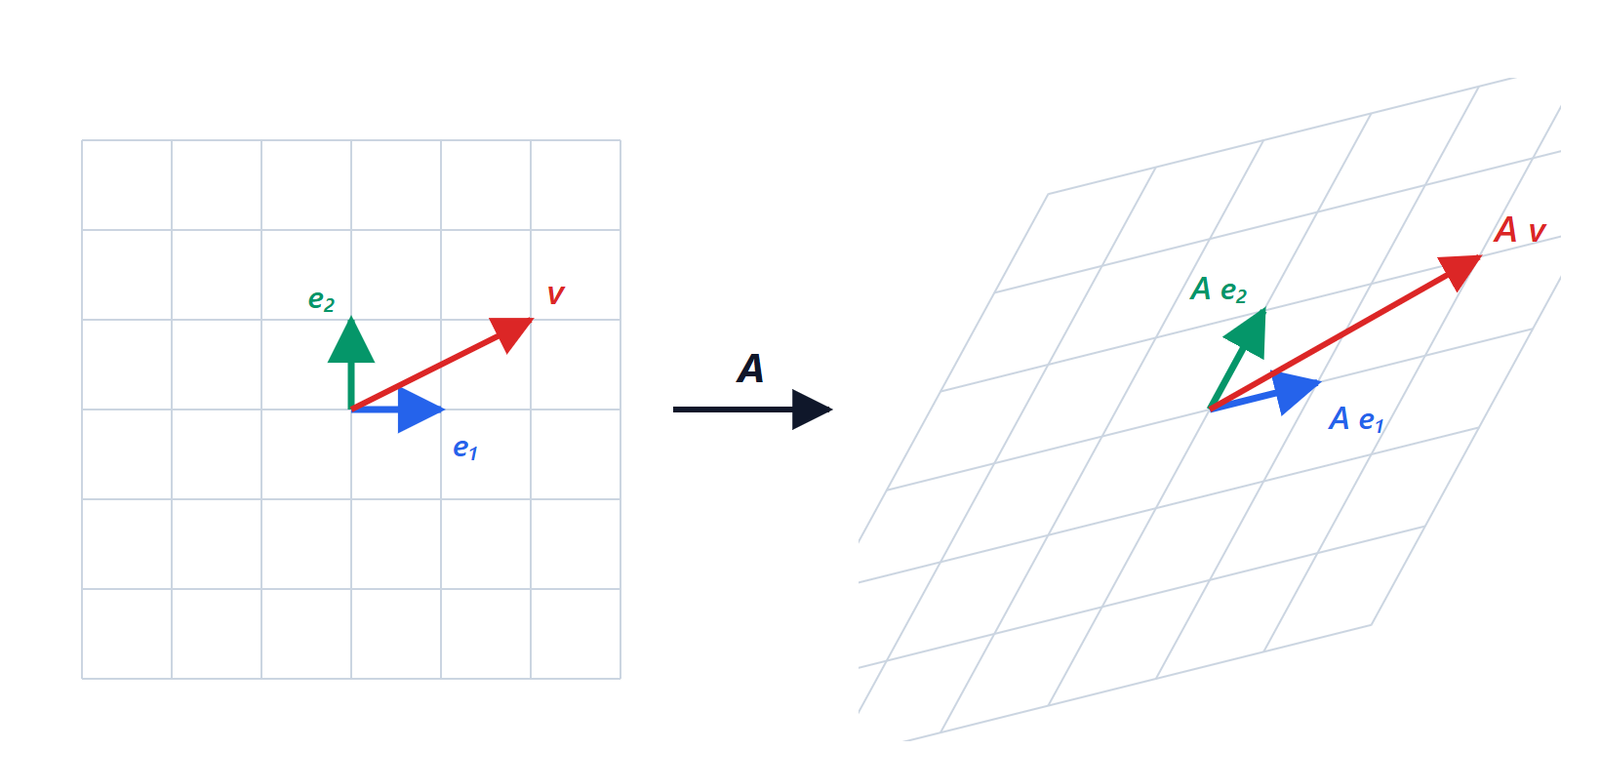
 ed
 (le colonne di ) per sapere dove va ogni vettore:
 ha rispetto ad
 le stesse coordinate che
 ha rispetto a
 .
Esempio: la rotazione. Ruotando di ,  va in
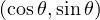 ed
 va in
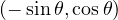 . Quindi
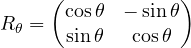
Componendo due rotazioni, 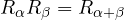 : sviluppando il prodotto si ritrovano le formule di addizione del seno e del coseno, senza doverle ricordare.
Esempio: la derivata. Su  con base
 :
 ,
 ,
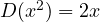 . Le coordinate di queste immagini sono le colonne:
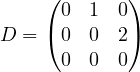
Derivare  equivale a moltiplicare
 per
 : si ottiene
 , cioè
 .
Nucleo e immagine
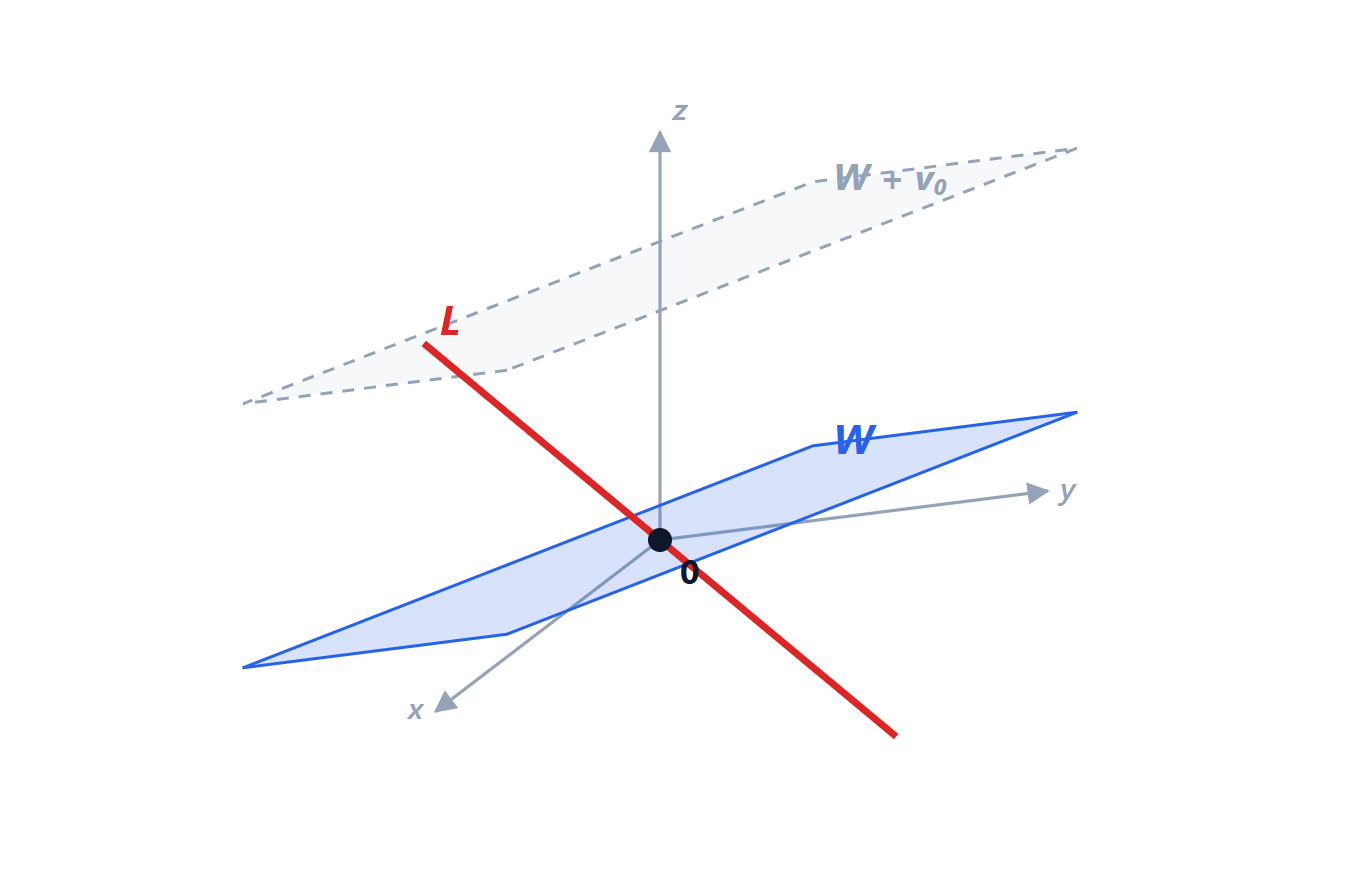
- Il nucleo
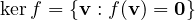 è un sottospazio di
 : per una matrice, sono le soluzioni del sistema omogeneo
 .
- L’immagine
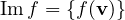 è un sottospazio di
 : per una matrice, è lo spazio generato dalle colonne, e la sua dimensione è il rango.
 è iniettiva se e solo se
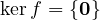 . Infatti
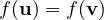 equivale a
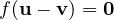 , cioè
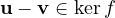 . è suriettiva se e solo se
 .
Il teorema della dimensione
Teorema (nullità più rango). Se è lineare e ha dimensione finita,
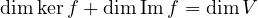
Dimostrazione
Sia  una base di
 . La completiamo a una base di aggiungendo
 , con
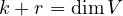 . Mostriamo che
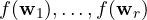 è una base dell’immagine, così
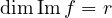 .
Generano. Ogni è 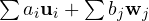 , e
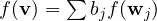 perché
 .
Sono indipendenti. Se 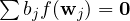 , allora
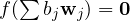 , quindi
 sta nel nucleo e si scrive come
 . Ma allora
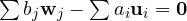 è una combinazione nulla di vettori di una base di : tutti i coefficienti sono zero, in particolare i
 .
Per una matrice di rango  il teorema dice che
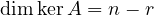 : è il numero di parametri liberi del teorema di Rouché-Capelli, che così è dimostrato del tutto.
Conseguenze. Un’applicazione lineare da in sé stesso è iniettiva se e solo se è suriettiva (se e solo se è invertibile). Un’applicazione da  a
 non può essere iniettiva: il nucleo ha almeno dimensione 1. Una da a non può essere suriettiva.
Cambiamento di base
La matrice di un’applicazione dipende dalla base scelta. Se  è la matrice che ha come colonne i vettori di una nuova base (scritti nella base vecchia), le coordinate si trasformano con
 , e la matrice dell’applicazione
 nella nuova base è
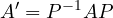
Due matrici legate così si dicono simili: rappresentano la stessa trasformazione vista da due sistemi di riferimento diversi. Hanno lo stesso determinante, lo stesso rango, la stessa traccia e gli stessi autovalori. Scegliere la base giusta per rendere  il più semplice possibile, magari diagonale, è proprio il tema della prossima lezione.